 AD광고
New경이롭고 치열한 생존 이야기극한 진화의 세계
 AD광고
Best Seller소년 김구의 가슴 뜨거운 역사설민석의 한국사 대모험 38
적립금
900원 (5% 적립)
추가 적립
추가 적립 안내
5만원 이상 결제 시 (*배송비 제외)
정가제FREE(상품/사은품) 금액이 2,000원 이상이면 2,000원 추가적립
10만원 이상 결제 시 (*배송비 제외)
정가제FREE(상품/사은품) 금액이 2,000원 이상이면 2,000원 추가적립
정가제FREE(상품/사은품) 금액이 5,000원 이상이면 5,000원 추가적립
결제혜택
무이자 할부
신용카드 무이자할부 안내
결제사 혜택
결제사 혜택 안내
쿠폰
등록 페이지로 이동
배송비
무료 (해외배송의 경우 지역에 따라 상이)
배송안내
서울특별시 강남구 강남대로 542(논현동, 영풍빌딩)
- 배송지역 선택
- 주소 검색
지금 택배 주문하면 9/30(수) 출고 가능
택배보다 빠른, 나우드림
16,200원
[네이버페이]
상품 규격 정보
| ISBN | ISBN-13 : 9791139230833 |
|---|---|
| 쪽수 | 240쪽 |
| 크기 | A5(148mm X 210mm, 국판) |
| 제품구성 | 단행본 |
이 책이 속한 분야
- 인문/역사 > 출판학
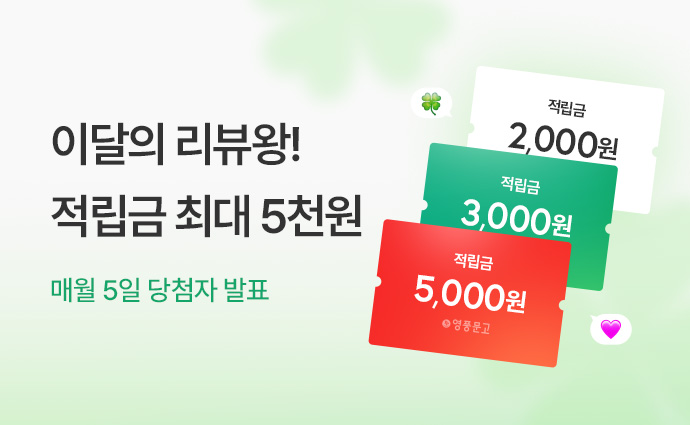
관련 이벤트
책 소개
목차
출판사 서평
저자 소개
도서리뷰
이 책을 읽고 어떤 느낌을 받으셨나요? 리뷰를 남기고 다른 독자들과 함께 공유해보세요.
구매(배송/수령완료) 후 리뷰를 작성하시면 적립금 300원을 드려요!
회원 총 평점
5 / 5
전체 리뷰수 1
5점
4점
3점
2점
1점

사용자 평점
5- y311***
- 2026.03.10
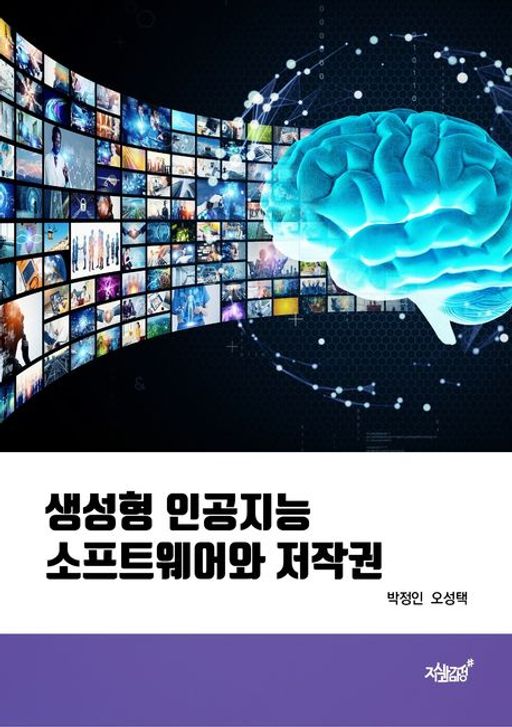
📚 [서점용 리뷰] 생성형 인공지능 소프트웨어와 저작권 1. 공정위 문구 본 리뷰는 출판사로부터 도서를 제공받아 주관적인 견해를 바탕으로 작성하였습니다. 2. 책 출처 도서명: 생성형 인공지능 소프트웨어와 저작권 저자: 박정인, 오성택 출판사: 지식과감성 3. 한줄평 "디지털 대항해 시대를 살아가는 현대인의 필수품, 창작의 존엄과 법적 질서를 잇는 든든한 짝꿍." 4. 깊은 읽기와 독후감 AI가 창작의 영역까지 넘보는 시대, 이 책은 우리가 반드시 챙겨야 할 '권리'의 지침서입니다. 저자들은 AI 학습 데이터의 저작권 문제부터 결과물의 권리 귀속까지, 복잡한 법적 쟁점을 현대인의 눈높이에서 명쾌하게 풀어냅니다. 기술이 아무리 정교해져도 그 뿌리에는 늘 '사람'과 '고유함'이 있어야 한다는 사실을 일깨워줍니다. 창작자로서 자신의 결과물을 보호하고, 인공지능과 지혜롭게 공존하고 싶은 분들이라면 곁에 두고 수시로 펼쳐봐야 할 현대 생활의 필수 지침서로 추천합니다. 5. 해시태그 #생성형AI #저작권 #필독서 #현대생활의짝꿍 #박정인 #오성택 #창작자의권리 #신간추천 #북리뷰 #지식재산권 #윤집사의서재
이 분야에서 요즘 뜨는 책


읽지 않는 사람들 - AI만 읽는 시대 퇴화하는 인간 지능에 관한 경고나오미 배런 | 웅진지식하우스
중독은 뇌를 어떻게 바꾸는가 - 충동에 사로잡힌 이들을 위한 처방전저드슨 브루어 | 알에이치코리아
세상은 실제로 어떻게 돌아가는가 - 우리의 문명을 정확하게 이해하기 위한 과학적 접근바츨라프스밀 | 김영사
팩트풀니스 - 50만 부 뉴에디션한스 로슬링, 올라 로슬링, 안나 로슬링 뢴룬드 | 김영사
AI가 나보다 일을 잘할 때 (교양 100그램 11)김대식,김혜연 | 창비
지능 파산 - AI 시대 편리함에 갇혀 버린 사람들한소원 | 바다출판사
진화의 가속도 - AI의 마음은 어떻게 만들어지고 진화하는가레이 커즈와일 | 촐라체
문해내공 - AI 시대 생존을 넘어 품격을 만드는 국어력의 힘신종호,김윤정 | 상상스퀘어
읽지 않는 사람들 - AI만 읽는 시대 퇴화하는 인간 지능에 관한 경고나오미 배런 | 웅진지식하우스
중독은 뇌를 어떻게 바꾸는가 - 충동에 사로잡힌 이들을 위한 처방전저드슨 브루어 | 알에이치코리아
세상은 실제로 어떻게 돌아가는가 - 우리의 문명을 정확하게 이해하기 위한 과학적 접근바츨라프스밀 | 김영사
팩트풀니스 - 50만 부 뉴에디션한스 로슬링, 올라 로슬링, 안나 로슬링 뢴룬드 | 김영사
AI가 나보다 일을 잘할 때 (교양 100그램 11)김대식,김혜연 | 창비
지능 파산 - AI 시대 편리함에 갇혀 버린 사람들한소원 | 바다출판사
진화의 가속도 - AI의 마음은 어떻게 만들어지고 진화하는가레이 커즈와일 | 촐라체
문해내공 - AI 시대 생존을 넘어 품격을 만드는 국어력의 힘신종호,김윤정 | 상상스퀘어
이 분야의 화제의 신간
인간을 위한 공간 - 인간의 감정과 행동을 조율하는 공간의 원칙다비데 루촌 | 포레스트북스
메모의 문화사 - 다빈치 노트에서 디지털 메모장까지 안심하고 잊기 위해 적은 사적 기록의 역사(Philos 시리즈 53)헥토어 하르쾨터 | 아르테
늙지 않는 미래 - 질병과 노화가 제어된 미래를 한 걸음 앞서 맞이하는 법니나 루게 | 삼호미디어
숲문해력 : 숲에서 세상을 읽다 - 인간은 어떻게 숲을 잃어버렸는가남효창 | 책이라는신화
사이토 다카시의 니체는 이렇게 말했다 - 무례한 세상에 휘둘리지 않기 위한 니체의 말사이토 다카시 | 부키
그대들은 어떻게 살 것인가 - 인공지능이 결코 계산할 수 없는 것들에 관하여이영환 | 앵글북스
늙음의 레슨 - 쓸데없는 짓을 하지 않는 어른이 되었습니다우치다 타츠루 | 유유
나이는 어떻게 힘이 되는가 - 과학과 철학이 증명하는 평생 현역의 원리박상철 | 시공사
인간을 위한 공간 - 인간의 감정과 행동을 조율하는 공간의 원칙다비데 루촌 | 포레스트북스
메모의 문화사 - 다빈치 노트에서 디지털 메모장까지 안심하고 잊기 위해 적은 사적 기록의 역사(Philos 시리즈 53)헥토어 하르쾨터 | 아르테
늙지 않는 미래 - 질병과 노화가 제어된 미래를 한 걸음 앞서 맞이하는 법니나 루게 | 삼호미디어
숲문해력 : 숲에서 세상을 읽다 - 인간은 어떻게 숲을 잃어버렸는가남효창 | 책이라는신화
사이토 다카시의 니체는 이렇게 말했다 - 무례한 세상에 휘둘리지 않기 위한 니체의 말사이토 다카시 | 부키
그대들은 어떻게 살 것인가 - 인공지능이 결코 계산할 수 없는 것들에 관하여이영환 | 앵글북스
늙음의 레슨 - 쓸데없는 짓을 하지 않는 어른이 되었습니다우치다 타츠루 | 유유
나이는 어떻게 힘이 되는가 - 과학과 철학이 증명하는 평생 현역의 원리박상철 | 시공사
이 분야의 주간 베스트셀러
위버멘쉬 - 누구의 시선도 아닌 내 의지대로 살겠다는 선언프리드리히 니체 | RISE(떠오름)
리더는 언제 차이를 만들어내는가 - 기업가 예언자 감독 그리고 왕재레드 다이아몬드 | 김영사
손자병법 - 이겨놓고 싸우는 인생의 지혜 (현대지성 클래식 69)손자 | 현대지성
다크 심리학다크 사이드 프로젝트 | 어센딩
세네카 오늘을 빼앗기고 있는 당신에게세네카 | 논픽션
니체의 초월자프리드리히 니체 | 히읏
쇼펜하우어 인생수업(30만 부 기념 개정증보판) - 한 번뿐인 삶 이렇게 살아라아르투어 쇼펜하우어 | 하이스트
오디세이아(명화와 함께 읽는) - 국내 유일 명화 104점 수록 완역본(현대지성 클래식 65)호메로스 | 현대지성
위버멘쉬 - 누구의 시선도 아닌 내 의지대로 살겠다는 선언프리드리히 니체 | RISE(떠오름)
리더는 언제 차이를 만들어내는가 - 기업가 예언자 감독 그리고 왕재레드 다이아몬드 | 김영사
손자병법 - 이겨놓고 싸우는 인생의 지혜 (현대지성 클래식 69)손자 | 현대지성
다크 심리학다크 사이드 프로젝트 | 어센딩
세네카 오늘을 빼앗기고 있는 당신에게세네카 | 논픽션
니체의 초월자프리드리히 니체 | 히읏
쇼펜하우어 인생수업(30만 부 기념 개정증보판) - 한 번뿐인 삶 이렇게 살아라아르투어 쇼펜하우어 | 하이스트
오디세이아(명화와 함께 읽는) - 국내 유일 명화 104점 수록 완역본(현대지성 클래식 65)호메로스 | 현대지성
이 분야의 새로 나온 도서
사서로운 독서 - 사서교사의 사적인 독서 에세이나현정 | 바른북스
AI가 답할수록 공간은 질문한다 - AI 시대 사람을 배우게 하는 공간의 조건김재순 | 바른북스
트랜스패런시 - 중국천하시대 한국 산업의 길김평희 | 바른북스
한국 역사GIS - 시공간 데이터로 복원한 역사 공간한국문화역사지리학회 | 앨피
인간 이야기 신화소(서강인문정신 23)황윤정 | 서강대학교출판부
빌런의 퍼스널컬러 - 색으로 보는 영화 속 빌런의 미학천영서 | 스피어인
홍익인간 : 널리 이익을 주는 인간효암 김영태 | 어문학사
민청련 두꺼비 열전 - 민주화운동청년연합 청년들의 삶과 투쟁권형택,김성환,임경석,조명자 | 시대의창출판사
사서로운 독서 - 사서교사의 사적인 독서 에세이나현정 | 바른북스
AI가 답할수록 공간은 질문한다 - AI 시대 사람을 배우게 하는 공간의 조건김재순 | 바른북스
트랜스패런시 - 중국천하시대 한국 산업의 길김평희 | 바른북스
한국 역사GIS - 시공간 데이터로 복원한 역사 공간한국문화역사지리학회 | 앨피
인간 이야기 신화소(서강인문정신 23)황윤정 | 서강대학교출판부
빌런의 퍼스널컬러 - 색으로 보는 영화 속 빌런의 미학천영서 | 스피어인
홍익인간 : 널리 이익을 주는 인간효암 김영태 | 어문학사
민청련 두꺼비 열전 - 민주화운동청년연합 청년들의 삶과 투쟁권형택,김성환,임경석,조명자 | 시대의창출판사
교환/반품/환불
| 반품/교환방법 |
|
|---|---|
| 반품/교환 가능기간 |
|
| 반품/교환비용 |
|
| 반품/교환 불가 사유 |
|
| 상품 품절 |
|
| 소비자 피해보상 환불지연에 따른 배상 |
|
16,200원
>
등록 페이지로 이동
공지사항공지더보기