AD광고
AD광고
- 베스트
- 소득공제
- 무료배송
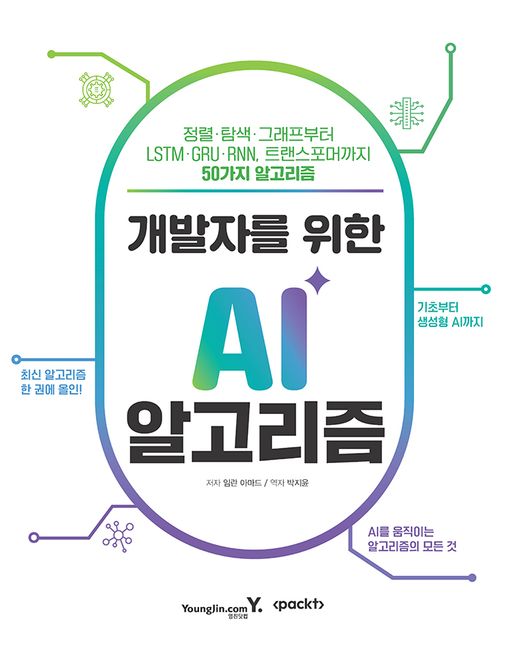
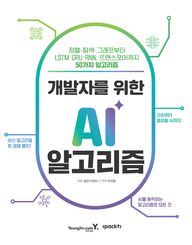
개발자를 위한 AI 알고리즘 - 정렬 탐색 그래프부터 LSTM GRU RNN 트랜스포머까지 50가지 알고리즘
- 임란 아마드 저
- 박지윤 역
- 영진닷컴
- 2025년 12월 05일
5만원 이상 결제 시 (*배송비 제외)
정가제FREE(상품/사은품) 금액이 2,000원 이상이면 2,000원 추가적립
10만원 이상 결제 시 (*배송비 제외)
정가제FREE(상품/사은품) 금액이 2,000원 이상이면 2,000원 추가적립
정가제FREE(상품/사은품) 금액이 5,000원 이상이면 5,000원 추가적립
신용카드 무이자할부 안내
결제사 혜택 안내


배송안내
- 배송지역 선택
- 주소 검색
| 네이버페이 구매하기 | 찜하기 |
[네이버페이]
| ISBN | ISBN-13 : 9788931481556 |
|---|---|
| 쪽수 | 544쪽 |
| 크기 | 기타 규격 |
| 제품구성 | 단행본 |
- 컴퓨터/IT > 시스템공학
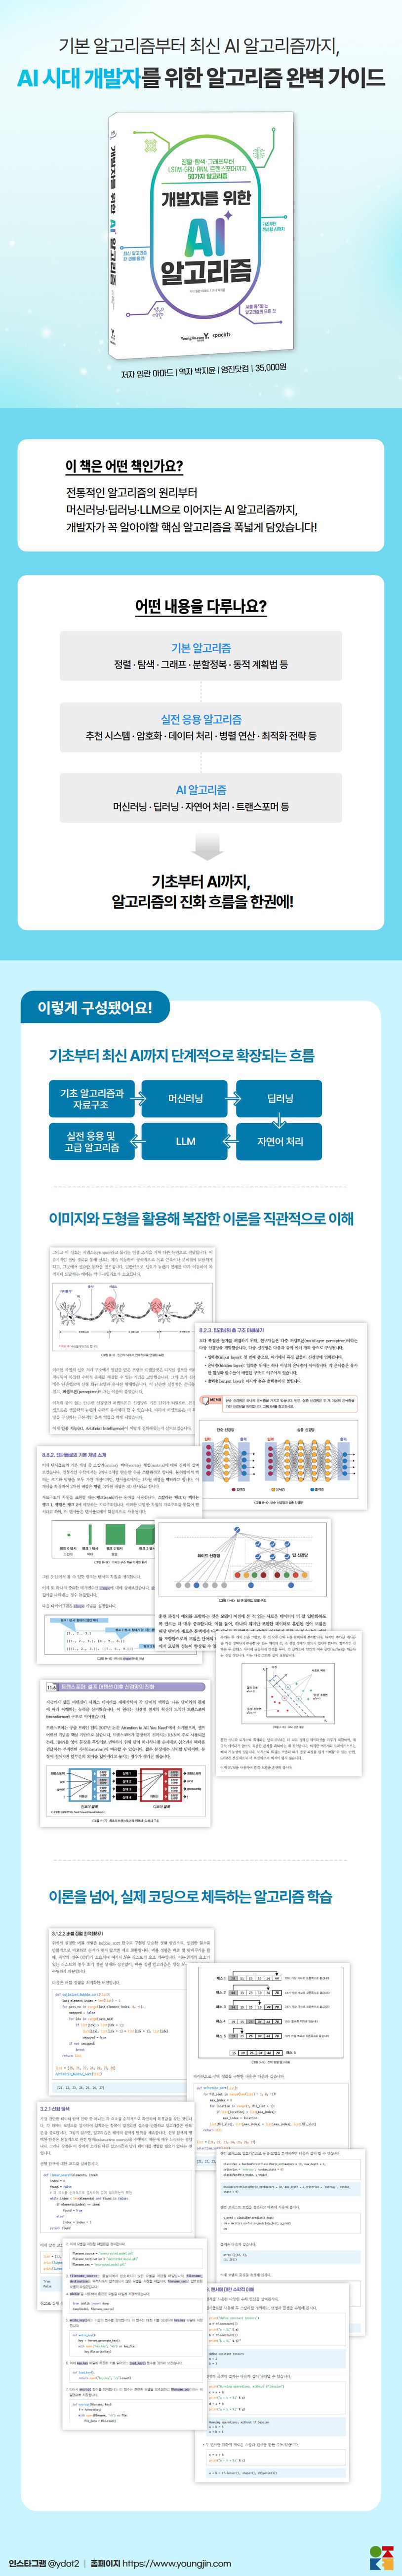
AI 시대 개발자가 반드시 알아야 할 알고리즘의 핵심을 한 권에 담았다.
현대 개발자가 반드시 이해해야 할 알고리즘의 핵심을 한 권에 담은 실전 중심 알고리즘 가이드이다. 이 책은 기초적인 정렬·탐색·그래프 알고리즘부터 머신러닝, 딥러닝, 자연어 처리, 추천 시스템, 암호학, 대규모 알고리즘 처리까지 폭넓게 다루며, 알고리즘을 활용해 실제 문제를 해결하는 능력을 기르는 데 초점을 맞춘다.
특히 최근 주목받고 있는 생성형 AI와 대규모 언어 모델(LLM)을 이해하기 위한 토대를 제공하며, LSTM·GRU·RNN 등 순차 모델의 원리와 구조를 자세히 설명한다. ChatGPT를 비롯한 LLM이 어떤 알고리즘과 모델을 기반으로 동작하는지 이해할 수 있도록 구성되어 있어, AI 시대에 필요한 필수 역량을 자연스럽게 습득할 수 있다.
각 알고리즘은 Python 기반 예제로 구현 과정을 함께 제공하여 누구나 직접 실습하며 따라갈 수 있으며, 특정 문제에 어떤 알고리즘을 선택해야 하는지, 어떻게 설계·최적화해야 하는지 실무적인 관점에서 안내한다.
알고리즘을 처음 배우려는 개발자부터 최신 AI 기술을 이해하고 활용하고자 하는 현업 실무자까지, 폭넓은 독자층이 실질적인 도움을 받을 수 있는 책이다.
[목 차]
〈1부〉 기초 및 핵심 알고리즘
1장 알고리즘 개요
1.1 알고리즘이란 무엇인가?
1.1.1 알고리즘의 단계
1.1.2 개발 환경
1.2 파이썬 패키지
1.2.1 SciPy 생태계
1.3 알고리즘 설계 기법
1.3.1 데이터 차원
1.3.2 계산 차원
1.4 성능 분석
1.4.1 공간 복잡도 분석
1.4.2 시간 복잡도 분석
1.4.3 성능 평가
1.4.4 빅오 표기법
1.4.5 상수 시간(O(1)) 복잡도
1.4.6 선형 시간(O(n)) 복잡도
1.4.7 2차 시간(O(n2)) 복잡도
1.4.8 로그 시간(O(logn)) 복잡도
1.5 알고리즘 선택하기
1.6 알고리즘 검증
1.6.1 정확한 알고리즘, 근사 알고리즘, 무작위 알고리즘
1.6.2 설명 가능성
2장 알고리즘에 사용되는 자료 구조
2.1 파이썬 내장 자료형 탐색하기
2.1.1 리스트
2.1.2 튜플
2.1.3 딕셔너리와 세트
2.1.4 시리즈와 데이터프레임 사용하기
2.1.5 행렬
2.2 추상 자료형 탐색하기
2.2.1 벡터
2.2.2 스택
2.2.3 큐
2.2.4 트리
3장 정렬 및 탐색 알고리즘
3.1 정렬 알고리즘 소개
3.1.1 파이썬에서 변수 교환하기
3.1.2 버블 정렬
3.1.3 삽입 정렬
3.1.4 병합 정렬
3.1.5 셸 정렬
3.1.6 선택 정렬
3.1.7 정렬 알고리즘 선택하기
3.2 탐색 알고리즘 소개
3.2.1 선형 탐색
3.2.2 이진 탐색
3.2.3 보간 탐색
3.3 실용 예제
4장 알고리즘 설계
4.1 알고리즘 설계의 기본 개념 소개
4.1.1 고려 1 - 정확성: 우리가 기대한 결과를 생성하고 있는가
4.1.2 고려 2 - 성능: 최적의 방식인가?
4.1.3. 고려 3 - 확장성: 더 큰 데이터세트에서 어떻게 작동할 것인가?
4.2 알고리즘 전략 이해하기
4.2.1. 분할 정복 전략 이해하기
4.2.2. 동적 프로그래밍 전략 이해하기
4.2.3. 탐욕 알고리즘 이해하기
4.3 실제 응용 - 외판원 문제(TSP) 해결
4.3.1. 무차별 대입 전략 사용하기
4.3.2. 탐욕 알고리즘 사용하기
4.3.3. 세 가지 전략 비교
4.4 페이지랭크 알고리즘 소개
4.4.1. 문제 정의
4.4.2. 페이지랭크 알고리즘 구현하기
4.5 선형 프로그래밍 이해하기
4.5.1. 선형 프로그래밍 문제 공식화하기
4.5.2. 실용 예제 - 선형 프로그래밍으로 공급능력 계획하기
5장 그래프 알고리즘
5.1 그래프 이해하기: 간단한 소개
5.1.1. 그래프: 현대 데이터 네트워크의 중추
5.1.2. 그래프 기초: 정점(혹은 노드)
5.2 그래프 이론과 네트워크 분석
5.3 그래프 표현 방식
5.4 그래프의 구조와 종류
5.4.1. 자아 중심 네트워크
5.5 네트워크 분석 이론 소개
5.5.1. 최단 경로 이해하기
5.5.2. 중심성 지표 이해하기
5.5.3. 파이썬으로 중심성 계산하기
5.5.4. 소셜 네트워크 분석
5.6 그래프 순회 이해하기
5.6.1. BFS
5.6.2. DFS
5.7 사례 연구: 소셜 네트워크 분석으로 사기 탐지하기
5.7.1. 도입
5.7.2. 사례 연구에서 사기란 무엇인가?
5.7.3. 단순한 사기 분석 수행하기
5.7.4. 감시탑 사기 분석 방법 소개
〈2부〉 머신 러닝 알고리즘
6장 비지도 머신 러닝 알고리즘
6.1 비지도 학습 개요
6.1.1. 데이터 마이닝 생명 주기에서 비지도 학습
6.1.2. 비지도 학습의 현재 연구 경향
6.1.3. 실용 예제
6.2 클러스터링 알고리즘 이해하기
6.2.1. 유사도 계산하기
6.2.2. k-평균 클러스터링 알고리즘
6.3 계층적 클러스터링의 단계
6.4 계층적 클러스터링 알고리즘 코드 작성하기
6.5 DBSCAN 이해하기
6.6 파이썬으로 DBSCAN을 사용하여 클러스터 생성하기
6.7 클러스터 평가하기
6.7.1. 클러스터링 응용 분야
6.8 차원 축소
6.8.1. 주성분 분석
6.9 연관 규칙 마이닝
6.9.1. 규칙의 종류
6.9.2. 연관 규칙 마이닝을 위한 알고리즘
7장 전통적인 지도 학습 알고리즘
7.1 지도 학습 이해하기
7.2 지도 학습 문제 공식화하기
7.2.1. 가능 조건 이해하기
7.2.2. 분류 모델과 회귀 모델 차이 구분하기
7.3 분류 알고리즘 이해하기
7.3.1. 분류 모델 과제 소개
7.3.2. 혼동 행렬
7.3.3. 재현율과 정밀도 간의 트레이드 오프 이해하기
7.4 결정 트리 분류 알고리즘
7.4.1. 결정 트리 분류 알고리즘 이해하기
7.4.2. 결정 트리 분류 모델의 장단점
7.4.3. 사용 사례
7.5 앙상블 기법 이해하기
7.5.1. XGBoost 알고리즘으로 그라디언트 부스팅 구현하기
7.5.2. 앙상블 부스팅과 랜덤 포레스트 알고리즘의 차이 구분하기
7.5.3. 분류 모델 과제에 랜덤 포레스트 알고리즘 활용하기
7.6 로지스틱 회귀
7.6.1. 가정
7.6.2. 관계 설정하기
7.6.3. 손실 함수와 비용 함수
7.6.4. 로지스틱 회귀를 사용해야 하는 경우
7.6.5. 분류 모델 과제에 로지스틱 회귀 알고리즘 활용하기
7.7 SVM 알고리즘
7.7.1. 분류 모델 과제에 SVM 알고리즘 활용하기
7.7.2. 나이브 베이즈 알고리즘 이해하기
7.8 베이즈 정리
7.8.1. 확률 계산하기
7.8.2. 곱셈 법칙과 AND 사건
7.8.3. 일반적인 곱셈 법칙
7.8.4. OR 사건에 대한 덧셈 법칙
7.8.5. 분류 모델 과제에 나이브 베이즈 알고리즘 활용하기
7.9 분류 알고리즘의 승자는...
7.9.1. 회귀 알고리즘 이해
7.9.2. 회귀 모델 과제 소개
7.9.3. 회귀 모델 문제 정의
7.9.4. 과거 데이터셋 탐색하기
7.9.5. 데이터 처리 파이프라인을 활용한 특징 공학
7.10 선형 회귀
7.10.1. 단순 선형 회귀
7.10.2. 회귀 모델 평가하기
7.10.3. 다중 회귀
7.10.4. 회귀 모델 과제에 선형 회귀 알고리즘 활용하기
7.10.5. 선형 회귀는 언제 사용하는가?
7.10.6. 선형 회귀의 약점
7.10.7. 회귀 트리 알고리즘
7.10.8. 회귀 모델 문제에 회귀 트리 알고리즘 활용하기
7.10.9. 그라디언트 부스트 회귀 알고리즘
7.10.10. 회귀 모델 과제에 그라디언트 부스트 회귀 알고리즘 활용하기
7.11 회귀 알고리즘의 승자는...
7.12 실용 예제: 날씨 예측하기
8장 신경망 알고리즘
8.1 신경망의 진화
8.1.1. 역사적 배경
8.1.2. AI 겨울과 AI 봄의 시작
8.2 신경망 이해하기
8.2.1. 퍼셉트론 이해하기
8.2.2. 신경망 직관적으로 이해하기
8.2.3. 딥러닝의 층 구조 이해하기
8.3 신경망 훈련시키기
8.4 신경망의 구조 이해하기
8.5 경사 하강법 정의하기
8.6 활성화 함수
8.6.1. 계단 함수
8.6.2. 시그모이드 함수
8.6.3. ReLU
8.6.4. 쌍곡 탄젠트(tanh)
8.6.5. 소프트맥스
8.7 도구 및 프레임워크
8.7.1. 케라스
8.8 순차적 모델 또는 함수형 모델 선택하기
8.8.1. 텐서플로 이해하기
8.8.2. 텐서플로의 기본 개념 소개
8.8.3. 텐서에 대한 수학적 이해
8.9 신경망 종류 이해하기
8.9.1. 합성곱 신경망
8.9.2. 생성적 적대 신경망
8.10 전이 학습 활용하기
8.11 사례 연구: 위조 문서 탐지에 딥 러닝 활용하기
8.11.1. 방법론
9장 자연어 처리를 위한 알고리즘
9.1 자연어 처리 개론
9.2 자연어 처리 용어 이해
9.2.1. 자연어 처리의 텍스트 전처리
9.3 파이썬으로 데이터 정제하기
9.4 단어 문서 행렬(Term Document Matrix) 이해
9.4.1. TF-IDF 사용하기
9.4.2. 결과 요약 및 논의
9.5 워드 임베딩 개론
9.6 Word2Vec으로 워드 임베딩 구현하기
9.6.1. 유사도 점수 해석
9.6.2. Word2Vec의 장단점
9.7 사례 연구: 레스토랑 리뷰 감성 분석
9.7.1. 필요 라이브러리 및 데이터셋 가져오기
9.7.2. 정제된 말뭉치 구축: 텍스트 데이터 전처리
9.7.3. 텍스트 데이터를 숫자 특징으로 변환하기
9.7.4. 결과 분석하기
9.8 자연어 처리 응용 분야
10장 순차 모델 이해하기
10.1 순차 데이터 이해
10.1.1. 순차 모델의 종류
10.2 순차 모델의 데이터 표현
10.3 RNN 개론
10.3.1. RNN 구조 이해
10.3.2. 첫 번째 타입스텝에서 RNN 훈련하기
10.3.3. 시간에 따른 역전파
10.3.4. 기본 RNN의 한계
10.4 GRU(게이트 순환 유닛)
10.4.1. 업데이트 게이트 소개
10.4.2. 업데이트 게이트 구현
10.4.3. 은닉 셀 업데이트하기
10.5 LSTM(장단기 메모리) 소개
10.5.1. 망각 게이트
10.5.2. 후보 셀 상태
10.5.3. 업데이트 게이트
10.5.4. 메모리 상태 계산하기
10.5.5. 출력 게이트
10.5.6. 모두 합치기
10.5.7. 순차 모델 코딩하기
11장 고급 순차 모델 알고리즘
11.1 고급 순차 모델 기법의 발전
11.2 오토인코더 탐색
11.2.1. 오토 인코더 코드 작성하기
11.2.2. 환경 준비
11.3 Seq2Seq 모델 이해하기
11.3.1. 인코더
11.3.2. 사고 벡터
11.3.3. 디코더
11.3.4. Seq2Seq의 특수 토큰
11.3.5. 정보 병목 딜레마
11.4 어텐션 메커니즘 이해
11.4.1. 신경망에서 어텐션이란?
11.4.2. 어텐션 메커니즘의 세 가지 주요 측면
11.4.3. 어텐션 메커니즘 더 깊이 들여다보기
11.4.4. 어텐션 메커니즘의 문제
11.5 셀프 어텐션 자세히 살펴보기
11.5.1. 어텐션 가중치
11.5.2. 인코더: 양방향 순환 신경망
11.5.3. 사고 벡터
11.5.4. 디코더: 일반 RNN
11.5.5. 훈련 대 추론
11.6 트랜스포머: 셀프 어텐션 이후 신경망의 진화
11.6.1. 트랜스포머가 빛나는 이유
11.6.2. 파이썬 코드 분석
11.6.3. 출력 결과 이해하기
11.7 대규모 언어 모델
11.7.1. LLM에서의 어텐션 이해하기
11.7.2. NLP의 대표 주자 탐색: GPT와 BERT
11.7.3. 강력한 LLM을 만들기 위한 딥 앤 와이드 모델 활용
11.8 딥 앤 와이드 모델
〈3부〉 심화 주제
12장 추천 엔진
12.1 추천 시스템 개론
12.2 추천 엔진 유형
12.2.1. 내용 기반 추천 엔진
12.2.2. 협업 필터링 추천 엔진
12.2.3. 혼합 추천 엔진
12.3 추천 시스템의 한계
12.3.1. 콜드 스타트 문제
12.3.2. 메타데이터 요구조건
12.3.3. 데이터 희소성 문제
12.3.4. 추천 시스템에서 사회적 영향이라는 양날의 검
12.4 응용 분야
12.4.1. 넷플릭스의 고도화된 데이터 기반 추천
12.4.2. 아마존 추천 시스템의 진화
12.5 실용 예제 - 추천 엔진 만들기
12.5.1. 프레임워크 설정하기
12.5.2. 데이터 불러오기: 리뷰 및 제목 가져오기
12.5.3. 데이터 병합: 종합적 관점 다듬기
12.5.4. 서술적 분석: 평점으로부터 통찰 도출하기
12.5.5. 추천을 위한 구조화: 행렬 만들기
12.5.6. 엔진 테스트: 영화 추천하기
13장 데이터 처리를 위한 알고리즘 전략
13.1 데이터 알고리즘 개론
13.1.1. 데이터 알고리즘에서 CAP 정리의 중요성
13.1.2. 분산 환경에서의 저장
13.1.3. CAP 정리와 데이터 압축의 연관성
13.2 CAP 정리 소개
13.2.1. CA 시스템
13.2.2. AP 시스템
13.2.3. CP 시스템
13.3 데이터 압축 알고리즘 제대로 이해하기
13.3.1. 무손실 압축 기법
13.4 실용 예제: CAP 정리와 압축 알고리즘에 초점을 맞춘 AWS의 데이터 관리
13.4.1. CAP 정리 적용하기
13.4.2. 압축 알고리즘 사용하기
13.4.3. 장점을 정량화하기
14장 암호화
14.1 암호학 개론
14.1.1. 가장 약한 연결고리의 중요성 이해하기
14.1.2. 기본 용어
14.1.3. 보안 요구사항 이해하기
14.1.4. 암호의 기본 설계 이해하기
14.2 암호화 기법의 종류 이해하기
14.2.1. 암호화 해시 함수 사용하기
14.2.2. 대칭 암호화 사용하기
14.2.3. 비대칭 암호화
14.3 예제: 머신 러닝 모델을 배포할 때의 보안 문제
14.3.1. 중간자 공격
15장 대규모 알고리즘
15.1 대규모 알고리즘 개론
15.2 대규모 알고리즘을 위한 고성능 인프라 특징
15.2.1. 탄력성
15.2.2. 잘 설계된 대규모 알고리즘의 특징
15.3 멀티 리소스 처리 전략 수립
15.4 병렬 컴퓨팅의 이론적 한계
15.4.1. 암달의 법칙
15.4.2. 암달의 법칙 도출하기
15.4.3. 병렬 컴퓨팅에서 GPU의 잠재력을 이끌어내는 CUDA
15.4.4. 아파치 스파크를 활용한 클러스터 컴퓨팅의 이점
15.5 아파치 스파크가 대규모 알고리즘 처리를 가능하게 하는 방법
15.5.1. 분산 컴퓨팅
15.5.2. 메모리 내 처리
15.6 클라우드 컴퓨팅에서 대규모 알고리즘 활용
15.6.1. 예제
16장 현실적 고려 사항
16.1 알고리즘 솔루션이 마주한 도전 과제
16.1.1. 예상치 못한 것을 예측하기
16.2 트위터 AI 봇, 테이의 실패
16.3 알고리즘의 설명 가능성
16.3.1. 머신 러닝 알고리즘과 설명 가능성
16.4 알고리즘 윤리 이해
16.4.1. 학습 알고리즘의 문제점
16.4.2. 윤리적 고려 사항 이해하기
16.4.3. 알고리즘 솔루션에 영향을 주는 요인
16.5 모델 편향 줄이기
16.6 알고리즘을 언제 사용할 것인가
16.6.1. 블랙스완 사건과 그것이 알고리즘에 미치는 영향 이해


등록된 리뷰가 없습니다
첫번째 리뷰어가 되어주세요


| 반품/교환방법 |
|
|---|---|
| 반품/교환 가능기간 |
|
| 반품/교환비용 |
|
| 반품/교환 불가 사유 |
|
| 상품 품절 |
|
| 소비자 피해보상 환불지연에 따른 배상 |
|
- [이벤트 당첨자 발표] 8월 모두의 서가 이벤트 당첨자 판매금액 리워드 안내
- [이벤트 당첨자 발표] 26년 8월 <리뷰왕을 찾아라> 이벤트 당첨자 안내
- [이벤트 당첨자 발표] 서울국제정원박람회, 김진명 작가 북토크 당첨자 안내
- [이벤트 당첨자 발표] 9월 모두의 서가 이벤트 당첨자 안내
- [공지사항] 스타필드마켓 월계 문구복합매장 그랜드 오픈 🎊 이벤트 안내!