• 메인으로 이동
    AD광고
    Best Seller소년 김구의 가슴 뜨거운 역사설민석의 한국사 대모험 38
    AD광고
    New사랑과 우정으로 빛나는 모험프린세스 캐치 티니핑
    • 소득공제
    • 무료배송

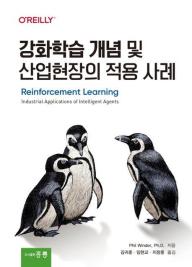
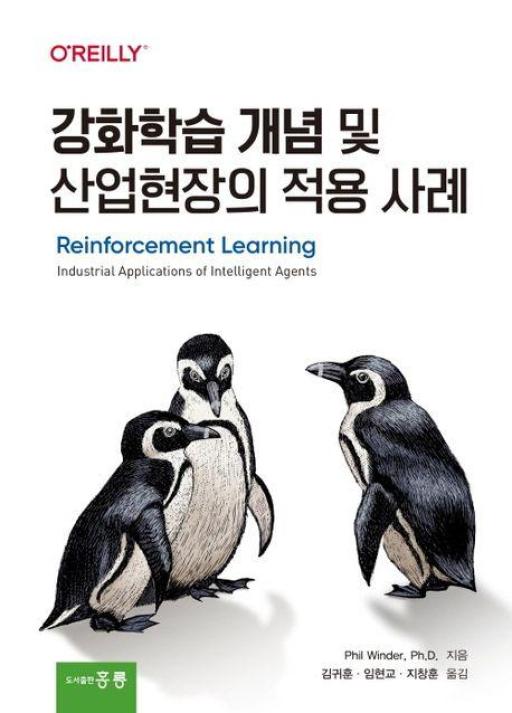
    강화학습 개념 및 산업현장의 적용사례

    • Phil Winder Ph.D. 저
    • 김귀훈,임현교,지창훈 역
    • 홍릉
    • 2023년 10월 27일
    1%31,680원32,000
    적립금
    960원 (3% 적립)
    추가 적립
    추가 적립 안내
    • 5만원 이상 결제 시 (*배송비 제외)

      정가제FREE(상품/사은품) 금액이 2,000원 이상이면 2,000원 추가적립

    • 10만원 이상 결제 시 (*배송비 제외)

      정가제FREE(상품/사은품) 금액이 2,000원 이상이면 2,000원 추가적립

      정가제FREE(상품/사은품) 금액이 5,000원 이상이면 5,000원 추가적립

    결제혜택
    무이자 할부
    결제사 혜택
    쿠폰
    회원 가입 즉시 지급되는 적립금 과 등급별 다양한 회원 혜택 보기
    배송비
    무료  (해외배송의 경우 지역에 따라 상이)

    배송안내

    서울특별시 강남구 강남대로 542(논현동, 영풍빌딩)
    지금 택배 주문하면 9/30(수) 출고 가능
    택배보다 빠른, 나우드림
    31,680원

    [네이버페이]

    상품 규격 정보
    상품상세정보
    ISBN ISBN-13 : 9791156001355
    쪽수386쪽
    크기기타 규격
    제품구성단행본
    이 책이 속한 분야
    • 컴퓨터/IT > 시스템공학
    관련 이벤트
    • 사은품

    이달의 리뷰왕

    2026.01.01 ~ 2026.12.31

    • 사은품

    신규가입시 최대 10,800원

    2025.12.31 ~ 2026.12.31

    • 사은품

    『디그 잇3』 출간기념 포토카드 증정 이벤트

    2026.09.14 ~ 2026.10.02

    • 사은품

    2026 추석 프로모션 - 영롱한 보름달처럼 풍성한 추석 혜택🌕

    2026.09.09 ~ 2026.09.27

    • 사은품

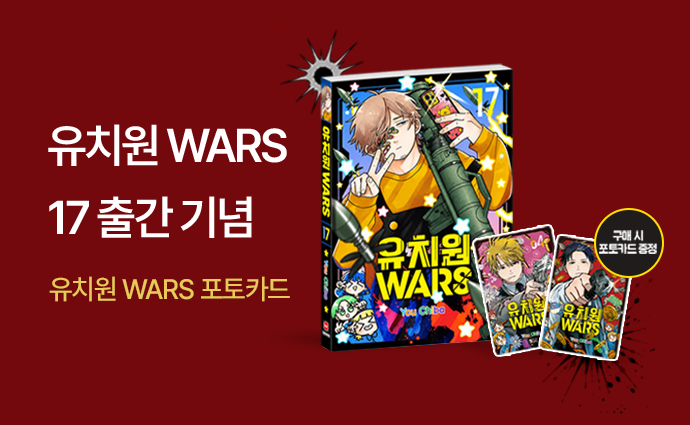
    『유치원 Wars 17』 출간 기념 포토카드 증정!

    2026.09.01 ~ 2026.09.28

    • 사은품

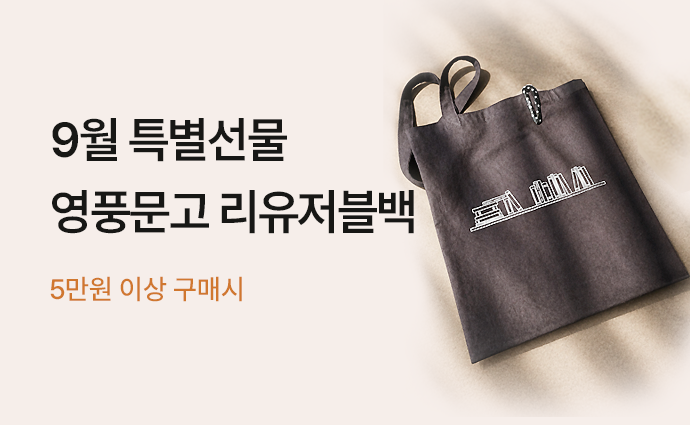
    9월 특별선물 《영풍문고 리유저블백》

    2026.09.01 ~ 2026.09.30

    • 사은품

    이달의 리뷰왕

    2026.01.01 ~ 2026.12.31

    • 사은품

    신규가입시 최대 10,800원

    2025.12.31 ~ 2026.12.31

    • 사은품

    『디그 잇3』 출간기념 포토카드 증정 이벤트

    2026.09.14 ~ 2026.10.02

    • 사은품

    2026 추석 프로모션 - 영롱한 보름달처럼 풍성한 추석 혜택🌕

    2026.09.09 ~ 2026.09.27

    목차
    CHAPTER 1 왜 강화 학습인가? 1.1 왜 지금 강화 학습이 필요한가? 1.2 기계 학습 1.3 강화 학습 1.3.1 언제 강화 학습을 사용해야 할까? 1.3.2 강화 학습을 적용한 어플리케이션 1.4 RL 접근 방식의 분류 1.4.1 Model-Free or Model-based 1.4.2 에이전트가 전략을 사용하고 업데이트하는 방법 1.4.3 이산(Discrete) 혹은 연속(Continuous) 행동 1.4.4 최적화 방법 1.4.5 정책 평가와 개선 1.5 강화 학습의 기본 개념 1.5.1 첫 번째 강화 학습 알고리즘 1.5.2 RL은 ML과 동일합니까? 1.5.3 보상과 피드백 1.6 학문으로서의 강화학습 1.7 요약 1.8 추가 자료 Reference CHAPTER 2 마르코프 결정 프로세스 , 동적 프로그래밍과 몬테카를로 방법 2.1 Multi-Arm Bandit 테스트하기 2.1.1 보상 엔지니어링 2.1.2 정책 평가: 가치 함수 2.1.3 정책 개선: 최고 행동 선택 2.1.4 시뮬레이션 환경 2.1.5 실험 실행 2.1.6 ε-greedy 알고리즘 개선하기 2.2 마르코프 의사 결정 프로세스(Markov Decision Process) 2.2.1 제고 관리 2.2.2 제고 관리 시뮬레이션 2.3 정책과 가치 함수 2.3.1 감가된 보상 2.3.2 상태-가치 함수로 보상 예측 2.3.3 행동-가치 함수로 보상 예측하기 2.3.4 최적의 정책 2.4 몬테카를로 정책 생성 2.5 동적 프로그래밍을 사용한 가치 반복 2.5.1 가치 반복 구현 2.5.2 가치 반복 결과 2.6 요약 2.7 추가 자료 Reference CHAPTER 3 시간차 학습, Q-learning 및 ?-스텝 알고리즘 3.1 시간차 학습의 정의 3.2 Q-러닝(Q-learning) 3.3 SARSA 3.4 Q-러닝과 SARSA 비교 3.5 연구 사례: 어플리케이션 컨테이너 자동 확장을 통한 비용 절감 3.6 산업 적용 사례: 광고 실시간 입찰 3.6.1 MDP 정의 3.6.2 실시간 입찰 환경의 결과 3.6.3 추가 개선 사항 3.7 Q-러닝의 확장 3.7.1 더블 Q-러닝(Double Q-learning) 3.7.2 지연 Q-러닝(Delayed Q-learning) 3.7.3 표준, 더블, 지연 Q-러닝 비교 3.7.4 대립학습(Opposition Learning) 3.8 n-스텝(n-Step) 알고리즘 3.9 그리드 환경에서 ?-스텝 알고리즘 3.10 타당성 추적(eligibility traces) 3.11 타당성 추적의 확장 3.11.1 Watkins’s Q(λ) 3.11.2 Fuzzy wipes in Watkins’s Q(λ) 3.11.3 빠른 Q-러닝(Speedy Q-Learning) 3.11.4 타당성 추적의 저장과 대체 3.12 요약 3.13 추가 자료 Reference CHAPTER 4 심층 Q-네트워크(Deep Q-Networks, DQN) 4.1 딥러닝 구조 4.1.1 딥러닝의 기본적인 구조 4.1.2 많이 사용하는 신경망 구조 4.1.3 딥러닝 프레임워크 4.1.4 심층 강화학습 4.2 심층 Q-러닝(Deep Q-Learning) 4.2.1 경험 재생(Experience Replay) 4.2.2 Q-네트워크 복제 4.2.3 뉴럴 네트워크 구조 4.2.4 DQN 구현 4.2.5 예제: CartPole 환경에서 DQN 4.2.6 연구 사례: 빌딩의 에너지 사용 감소 4.3 Rainbow DQN 4.3.1 분산 강화학습(Distributional RL) 4.3.2 우선 순위 기반 경험 재생(Prioritized Experience Replay, PER) 4.3.3 노이지 네트(Noisy Nets) 4.3.4 듀얼링 네트워크(Dueling Networks) 4.4 예제: Rainbow DQN의 Atrai Games 적용 4.4.1 결과 4.4.2 추가로 논의할 부분 4.5 다른 DQN 구현 4.5.1 탐험 개선 4.5.2 보상 개선 4.5.3 오프라인 데이터로 학습하기 4.6 요약 4.7 추가 자료 Reference CHAPTER 5 정책 기울기 메소드 5.1 정책 직접 학습의 장점 5.2 정책의 기울기를 계산하는 방법 5.3 정책 기울기(Policy Gradient) 이론 5.4 정책 함수(Policy Functions) 5.4.1 선형적인 정책(Linear Policies) 5.4.2 임의의 정책(Arbitrary Policies) 5.5 기본 구현(Basic Implementations) 5.5.1 몬테 카를로(REINFORCE) 5.5.2 베이스라인을 가진 REINFORCE 5.5.3 기울기 분산 감소 5.5.4 ?-스텝 액터-크리틱과 이득 액터-크리틱(Advantage Actor-Critic, A2C) 5.5.5 액터-크리틱의 타당성 추적(Eligibility Traces) 5.5.6 기본 정책 기울기 알고리즘 비교 5.6 산업 적용 사례: 소비자를 위한 자동 물품 구매 5.6.1 환경: Gym-Shopping-Cart 5.6.2 기대치 5.6.3 Shopping Cart 환경의 결과 5.7 요약 5.8 참고 자료 Reference CHAPTER 6 정책 기울기를 넘어 6.1 Off-Policy 알고리즘 6.1.1 중요도 샘플링(Importance Sampling) 6.1.2 행동과 타켓 정책 6.1.3 Off-Policy Q-러닝 6.1.4 기울기 시간차(Gradient Temporal-Difference, GTD) 학습 6.1.5 탐욕적-GQ 6.1.6 Off-Policy 액터-크리틱 6.2 결정론적 정책 기울기 6.2.1 결정론적 정책 기울기 6.2.2 심층 결정론적 정책 기울기(Deep Deterministic Policy Gradients, DDPG) 6.2.3 이중 지연된 심층 결정론적 정책 기울기(Twin Delayed DDPG, TD3) 6.2.4 연구 사례: 리뷰를 활용한 추천 6.2.5 DPG의 개선 6.3 신뢰 영역 방법(Trust Region Methods) 6.3.1 쿨백-라이블러(Kullback Leibler, KL) 발산 6.3.2 자연 정책 기울기(Natural Policy Gradients)와 신뢰 영역 정책 최적화(Trust Region Policy Optimization) 6.3.3 근접 정책 최적화(Proximal Policy Optimization, PPO) 6.4 예제: 실제 환경에서 원하는 곳에 도달하기 위한 서보 모터 활용하기 6.4.1 환경 설정 6.4.2 강화학습 알고리즘 구현 6.4.3 알고리즘의 복잡성 증가시키기 6.4.4 시뮬레이션에서 하이퍼파라미터 조정 6.4.5 정책들의 결과 6.5 그 밖의 다른 정책 기울기 알고리즘들 6.5.1 리트레이스(λ) 6.5.2 경험 재생 액터-크리틱(Actor-Critic with Experience Replay, ACER) 6.5.3 Kronecker-Factored 신뢰 영역을 활용한 액터 크리틱(Actor-Critic Using Kronecker-Factored Trust Regions, ACKTR) 6.5.4 강조적 방법 6.6 정책 기울기 알고리즘들의 확장 6.6.1 정책 기울기 알고리즘들의 분위수 회귀(Quantile Regression in Policy Gradient Algorithms) 6.7 요약 6.7.1 어떤 알고리즘을 사용해야 할까? 6.7.2 비동기적 방법 6.8 참고 문헌 Reference CHAPTER 7 엔트로피 방법과 연관된 정책 모두 배우기 7.1 엔트로피(Entropy)란 무엇일까? 7.2 최대 엔트로피 강화학습 7.3 소프트 액터-크리틱(Soft Actor-Critic, SAC) 7.3.1 SAC 구현 세부사항과 이산 행동 공간 7.3.2 자동 온도 매개변수 조정 7.3.3 연구 사례: 자동화된 교통 관리를 통한 대기 줄 감소 7.4 최대 엔트로피 방법들의 확장 7.4.1 다른 엔트로피 측정 방법들(그리고 앙상블) 7.4.2 더블 Q-러닝의 상한값을 사용한 낙관적 탐험(Optimistic Exploration) 7.4.3 경험 재생(Experience Replay)의 조정 7.4.4 부드러운 정책 기울기 7.4.5 부드러운 Q-러닝(Soft Q-Learning)과 그 유도 7.4.6 경로 일관성 학습(Path Consistency Learning) 7.5 성능 비교: SAC vs PPO 7.6 어떻게 엔트로피가 탐험을 장려시킬까? 7.6.1 온도 매개변수는 탐험을 어떻게 변화시킬까? 7.7 산업 적용 사례: 원격 차 운전 배우기 7.7.1 문제 정의 7.7.2 훈련 시간 최소화 7.7.3 극적인 행동들 7.7.4 하이퍼파라미터 탐색 7.7.5 최종 정책 7.7.6 추가적 개선 사항 7.8 요약 7.8.1 정책 기울기와 부드러운 Q-러닝 간의 등가성 7.8.2 이것이 미래에 의미하는 바는? 7.8.3 이것이 현재에 의미하는 바는? Reference CHAPTER 8 에이전트 학습 방법 개선 8.1 MDP에 대한 재고 8.1.1 부분적으로 관찰 가능한 마르코프 결정 프로세스(Partially Observable Markov Decision Process, POMDP) 8.1.2 연구 사례: 자율주행차에서 POMDP 사용 8.1.3 상황별 마르코프 의사 결정 프로세스 8.1.4 변경 행동이 있는 MDP 8.1.5 정규화된 MDP 8.2 계층적 강화 학습(Hierarchical Reinforcement Learning) 8.2.1 Naive 계층적 강화 학습 8.2.2 내재적 보상이 있는 고-저 수준 계층 구조(HIRO) 8.2.3 학습 기술 및 비지도 RL 8.2.4 HRL에서 기술 사용하기 8.2.5 HRL 결론 8.3 다중 에이전트 강화 학습(Multi-Agent Reinforcement Learning) 8.3.1 MARL 프레임워크 8.3.2 중앙집중식 혹은 비중앙집중식 8.3.3 단일 에이전트 알고리즘 8.3.4 연구 사례 : UAV에서 싱글 에이전트 분산 학습 사용 8.3.5 중앙 집중식 훈련, 비 중앙 집중식(분산) 실행 8.3.6 비중앙 집중식(분산/탈중앙식) 학습 8.3.7 다른 조합 방법 8.3.8 MARL의 과제 8.3.9 MARL의 결론 8.4 전문가의 가이드 8.4.1 행동 복제 8.4.2 모방 RL 8.4.3 Inverse RL 8.4.4 커리큘럼 RL 8.5 새로운 패러다임 8.5.1 메타 학습(Meta-Learning) 8.5.2 전이 학습(Transfer Learning) 8.6 요약 8.7 추가 자료 Reference CHAPTER 9 실용적인 강화 학습 9.1 RL 프로젝트 라이프 사이클 9.1.1 라이프 사이클 정의 9.2 문제 정의: RL 프로젝트란 무엇입니까? 9.2.1 순차적인 RL 문제들 9.2.2 전략적인 RL 문제들 9.2.3 저수준 RL 지표 9.2.4 학습의 종류 9.3 RL 공학 및 개선 9.3.1 프로세스(과정) 9.3.2 환경 공학 9.3.3 상태 공학 또는 상태 표현 학습 9.3.4 정책 공학 9.3.5 행동 공간에 정책 매핑 9.3.6 탐험 9.3.7 보상 엔지니어링(Reward Engineering) 9.4 요약 9.5 추가 자료 Reference CHAPTER 10 운영 강화 학습(Operational Reinforcement Learning) 10.1 구현 10.1.1 프레임워크 10.1.2 스케일링 RL 10.1.3 평가 10.2 배치 10.2.1 목표 10.2.2 아키텍쳐 10.2.3 보조 도구 10.2.4 안전성, 보안성, 윤리 10.3 요약 10.4 추가 자료 Reference CHAPTER 11 결론과 미래 11.1 팁과 속임수 11.1.1 문제 프레이밍 11.1.2 당신의 데이터 11.1.3 훈련 11.1.4 평가 11.1.5 배포 11.2 디버깅 11.2.1 ${ALGORITHM_NAME} Can’t Solve ${ENVIRONMENT}! 11.2.2 디버깅을 위한 모니터링 11.3 강화 학습의 미래 11.3.1 강화 학습의 시장성 11.3.2 미래의 강화학습과 연구 방향 11.4 끝 맺음 11.4.1 다음 단계 11.4.2 이제는 당신의 차례 11.5 추가 자료 Reference
    저자 소개
    저자 : Phil Winder Ph.D.
      Phil Winder Ph.D.
      출간 도서로는 『강화학습 개념 및 산업현장의 적용사례』 등이 있다.
      도서리뷰
      이 책을 읽고 어떤 느낌을 받으셨나요? 리뷰를 남기고 다른 독자들과 함께 공유해보세요.

      구매(배송/수령완료) 후 리뷰를 작성하시면 적립금 300원을 드려요!

      등록된 리뷰가 없습니다

      첫번째 리뷰어가 되어주세요

      이 분야에서 요즘 뜨는 책
      에러가 무섭지 않게 되는 책 - 에러 잘 읽는 법부터 효율적으로 디버깅하고 디버깅이 쉬운 코드를 작성하는 법까지사쿠라바 히로유키, 모치즈키 고타로 | 제이펍
      AI혁신:개정판 - 나의 커리어를 높이는 스마트워크 전략박대형, 김상용, 차명일, 임성기 | 지식과감성
      인생 언리얼 5 프로젝트 교과서 - 언리얼 엔진으로 3D 이머시브 콘텐츠 개발이영호, 박원석, 박현상, 탁광욱, 이영훈, 김현진 | BM성안당
      비전공자를 위한 이해할 수 있는 파이썬 - 챗GPT 시대에 최적화된 파이썬 공부법최원영 | 티더블유아이지
      엔트리 인공지능 with 햄스터 로봇 - 개정판강윤지,박찬규,강성웅,김원유,심재민,김연구,홍성용,김경상,정인재 | 영진닷컴
      에러가 무섭지 않게 되는 책 - 에러 잘 읽는 법부터 효율적으로 디버깅하고 디버깅이 쉬운 코드를 작성하는 법까지사쿠라바 히로유키, 모치즈키 고타로 | 제이펍
      AI혁신:개정판 - 나의 커리어를 높이는 스마트워크 전략박대형, 김상용, 차명일, 임성기 | 지식과감성
      인생 언리얼 5 프로젝트 교과서 - 언리얼 엔진으로 3D 이머시브 콘텐츠 개발이영호, 박원석, 박현상, 탁광욱, 이영훈, 김현진 | BM성안당
      비전공자를 위한 이해할 수 있는 파이썬 - 챗GPT 시대에 최적화된 파이썬 공부법최원영 | 티더블유아이지
      엔트리 인공지능 with 햄스터 로봇 - 개정판강윤지,박찬규,강성웅,김원유,심재민,김연구,홍성용,김경상,정인재 | 영진닷컴
      에러가 무섭지 않게 되는 책 - 에러 잘 읽는 법부터 효율적으로 디버깅하고 디버깅이 쉬운 코드를 작성하는 법까지사쿠라바 히로유키, 모치즈키 고타로 | 제이펍
      AI혁신:개정판 - 나의 커리어를 높이는 스마트워크 전략박대형, 김상용, 차명일, 임성기 | 지식과감성
      인생 언리얼 5 프로젝트 교과서 - 언리얼 엔진으로 3D 이머시브 콘텐츠 개발이영호, 박원석, 박현상, 탁광욱, 이영훈, 김현진 | BM성안당
      교환/반품/환불
      반품/교환방법
      • 마이페이지 > 주문관리 > 주문/배송조회 > 주문조회 후  [1:1상담신청]  또는 고객센터 (1544-9020)
      • ※ 오픈마켓, 해외배송 주문상품 문의 시 [1:1상담신청] 또는 고객센터 (1544-9020)
      반품/교환 가능기간
      • 변심반품의 경우 수령 후 7일 이내
      • 상품의 결함 및 계약내용과 다를 경우 문제점 발견 후 30일 이내
      반품/교환비용
      • 단순변심 혹은 구매착오로 인한 반품/교환은 반송료 고객 부담
      • 해외직배송 도서 구매 후 단순변심에 의한 취소 및 반품 시 도서판매가의 20% 수수료 부과
      반품/교환 불가 사유
      • 소비자의 책임 있는 사유로 상품 등이 손실 또는 훼손된 경우
      • 소비자의 사용, 포장 개봉에 의해 상품 등의 가치가 현저히 감소한 경우
        예) 만화, 잡지, 수험서 및 문제집류
      • 복제가 가능한 상품 등의 포장을 훼손한 경우
        예) 음반/DVD/비디오, 소프트웨어, 만화책, 잡지, 영상 화보집
      • 소비자의 요청에 따라 개별적으로 주문 제작되는 상품의 경우
      • 디지털 컨텐츠인 eBook, 오디오북 등을 1회 이상 다운로드를 받았을 경우
      • 시간의 경과에 의해 재판매가 곤란한 정도로 가치가 현저히 감소한 경우
      • 전자상거래 등에서의 소비자보호에 관한 법률이 정하는 소비자 청약철회 제한 내용에 해당되는 경우
      상품 품절
      • 공급사(출판사) 재고 사정에 의해 품절/지연될 수 있으며, 품절 시 관련 사항에 대해서는 이메일과 문자로 안내드리겠습니다.
      소비자 피해보상
      환불지연에 따른 배상
      • 상품의 불량에 의한 교환, A/S, 환불, 품질보증 및 피해보상 등에 관한 사항은 소비자분쟁 해결 기준 (공정거래위원회 고시)에 준하여 처리됨
      • 대금 환불 및 환불지연에 따른 배상금 지급 조건, 절차 등은 전자상거래 등에서의 소비자 보호에 관한 법률에 따라 처리함
      공지사항
      • [공지사항] 추석 연휴 전국 지점 영업시간 안내
      • [공지사항] [세종이마트점] 2026 추석 연휴 영업시간 안내
      • [공지사항] [인터넷 영풍문고] 2026년 추석 연휴 배송 일정 안내
      • [이벤트 당첨자 발표] 하나은행 나라사랑카드 <전역 PACK 도서 리뷰 작성 이벤트> 당첨자 안내
      • [이벤트 당첨자 발표] 26년 9월 <이달의 작가> 댓글 이벤트 당첨자 안내
      공지더보기