AD광고New행복을 선택하는 삶의 태도불행에 몰두하지 않는다
AD광고New사랑과 우정으로 빛나는 모험프린세스 캐치 티니핑

- 베스트
- 소득공제
- 무료배송
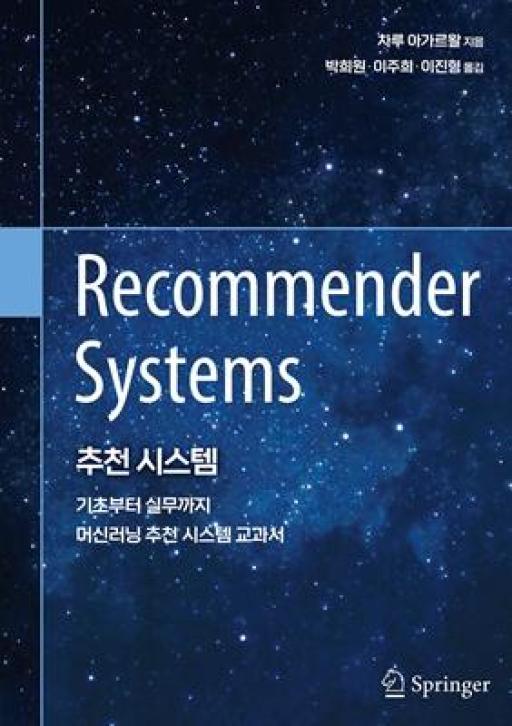
추천 시스템 : 기초부터 실무까지 머신러닝 추천 시스템 교과서(데이터 과학)
- 차루아가르왈 저
- 박희원,이주희,이진형 역
- 에이콘출판
- 2021년 12월 31일
5%38,000원40,000
적립금
1,600원 (4% 적립)
추가 적립
추가 적립 안내
5만원 이상 결제 시 (*배송비 제외)
정가제FREE(상품/사은품) 금액이 2,000원 이상이면 2,000원 추가적립
10만원 이상 결제 시 (*배송비 제외)
정가제FREE(상품/사은품) 금액이 2,000원 이상이면 2,000원 추가적립
정가제FREE(상품/사은품) 금액이 5,000원 이상이면 5,000원 추가적립
결제혜택
무이자 할부
신용카드 무이자할부 안내
결제사 혜택
결제사 혜택 안내
쿠폰
등록 페이지로 이동
배송비
무료 (해외배송의 경우 지역에 따라 상이)
배송안내
서울특별시 강남구 강남대로 542(논현동, 영풍빌딩)
- 배송지역 선택
- 주소 검색
지금 택배 주문하면 9/23(수) 출고 가능
택배보다 빠른, 나우드림
38,000원
NAVER 네이버 ID로 간편구매 네이버페이
| 네이버페이 구매하기 | 찜하기 |
[네이버페이]
상품 규격 정보
| ISBN | ISBN-13 : 9791161755878 |
|---|---|
| 쪽수 | 600쪽 |
| 크기 | 기타 규격 |
| 제품구성 | 단행본 |
이 책이 속한 분야
- 컴퓨터/IT > 시스템공학
관련 이벤트
책 소개
사용자의 이전 검색이나 구매를 기반으로 제품 또는 서비스의 개인화된 추천을 제공하는 추천 시스템을 포괄적으로 다룬다. 추천 시스템 방법은 쿼리 로그 마이닝, 소셜 네트워킹, 뉴스 추천 및 컴퓨터 광고를 포함한 다양한 애플리케이션에 적용됐다. 이 책은 알고리듬 및 평가, 특정 도메인 및 컨텍스트의 추천, 고급 주제 및 애플리케이션의 세 가지 범주로 구성했다. 기본적으로 교과서 역할을 하면서도 최근 주제와 애플리케이션도 함께 소개하므로 산업 종사자와 연구자들에게도 도움이 될 것이다. 수많은 예제와 연습 문제를 제공한다.
목차
1장. 추천 시스템 소개
1.1 개요
1.2 추천 시스템의 목표
1.21 추천 애플리케이션의 범위
1.3 추천 시스템의 기본 모델
1.3.1 협업 필터링 모델
1.3.1.1 평점의 종류
1.3.1.2 결측치 분석과의 관계
1.3.1.3 분류와 회귀 모델링의 일반화로써의 협업 필터링
1.3.2 콘텐츠 기반 추천 시스템
1.3.3 지식 기반 추천 시스템
1.3.31 효용 기반 추천 시스템
1.3.4 인구 통계학적 추천 시스템
1.3.5 하이브리드와 앙상블 기반 추천 시스템
1.3.6 추천 시스템의 평가
1.4 추천 시스템의 도메인 특화 과제
1.4.1 컨텍스트 기반 추천 시스템
1.4.2 시간에 민감한 추천 시스템
1.4.3 위치 기반 추천 시스템
1.4.4 소셜 추천 시스템
1.4.4.1 노드와 링크의 구조적 추천
1.4.4.2 사회적 영향을 고려한 제품과 콘텐츠 추천
1.4.4.3 신뢰할 수 있는 추천 시스템
1.4.4.4 소셜 태그 피드백을 활용한 추천
1.5 고급 주제 및 애플리케이션
1.5.1 추천 시스템의 콜드 스타트 문제
1.5.2 공격에 강한 추천 시스템
1.5.3 그룹 추천 시스템
1.5.4 다중 기준 추천 시스템
1.5.5 추천 시스템의 능동 학습
1.5.6 추천 시스템의 개인정보보호
1.5.7 애플리케이션 도메인
1.6 요약
1.7 참고문헌
1.8 연습 문제
2장. 이웃 기반 협업 필터링
2.1 개요
2.2 평점 행렬의 주요 특징
2.3 이웃 기반 방법론의 평점 예측
2.3.1 사용자 기반 이웃 모델
2.3.1.1 유사도 함수 변형
2.3.1.2 예측함수의 변형
2.3.1.3 피어 그룹 필터링의 변형
2.3.1.4 롱테일의 영향
2.3.2 아이템 기반 이웃 모델
2.3.3 효율적 구현 및 계산 복잡성
2.3.4 사용자 기반 방법론과 아이템 기반 방법론의 비교
2.3.5 이웃 기반 방법론의 장점과 단점
2.3.6 사용자 기반과 아이템 기반 방법론의 통합된 관점
2.4 클러스터링과 이웃 기반 방법론
2.5 차원 축소와 이웃 기반 방법론
2.5.1 바이어스 문제 처리
2.5.1.1 최대 우도 추정
2.5.1.2 불완전한 데이터의 직접 행렬 인수분해
2.6 이웃 방법론의 회귀 모델링 관점
2.6.1 사용자 기반 최근접 이웃 회귀
2.6.1.1 희소성 및 바이어스 문제
2.6.2 아이템 기반 가장 근접 이웃 회귀
2.6.3 사용자 기반 및 아이템 기반 방법 결합
2.6.4 유사도 가중치를 이용하는 조인트 보간법
2.6.5 희소 선형 모델(SLIM)
2.7 이웃 기반 방법에 대한 그래프 모델
2.7.1 사용자-아이템 그래프
2.7.1.1 랜덤 워크를 이용한 이웃 정의
2.7.1.2 카츠 척도를 이용한 이웃 정의
2.7.2 사용자-사용자 그래프
2.7.3 아이템-아이템 그래프
2.8 요약
2.9 참고문헌
2.10 연습 문제
3장. 모델 기반 협업 필터링
3.1 개요
3.2 의사 결정 및 회귀 트리
3.2.1 의사 결정 트리를 협업 필터링으로 확장
3.3 규칙 기반 협업 필터링
3.3.1 협업 필터링을 위한 레버리지 연관 규칙의 활용
3.3.2 아이템별 모델 대 사용자별 모델
3.4 나이브 베이즈 협업 필터링
3.4.1 과적합 조정
3.4.2 이진 평점에 대한 베이즈 방법의 적용 예
3.5 임의의 분류 모델을 블랙 박스로 사용
3.5.1 예: 신경망을 블랙 박스로 사용
3.6 잠재 요인 모델
3.6.1 잠재 요인 모델에 대한 기하학적 직관
3.6.2 잠재 요인 모델에 관한 저차원 직관
3.6.3 기본 행렬 인수분해 원리
3.6.4 제약 없는 행렬 인수분해
3.6.4.1 확률적 경사하강법
3.6.4.2 정규화
3.6.4.3 점진적 잠재성분 훈련
3.6.4.4 최소 제곱과 좌표 하강의 교차 적용
3.6.4.5 사용자 및 아이템 바이어스 통합
3.6.4.6 암시적 피드백 통합
3.6.5 특이값 분해
3.6.5.1 SVD에 대한 간단한 반복 접근법
3.6.5.2 최적화 기반 접근법
3.6.5.3 표본 외 추천
3.6.5.4 특이값 분해의 예
3.6.6 비음행렬 인수분해
3.6.6.1 해석 가능성의 장점
3.6.6.2 암시적 피드백을 사용한 인수분해에 대한 고찰
3.6.6.3 암시적 피드백에 대한 계산 및 가중치 문제
3.6.6.4 좋아요와 싫어요가 모두 있는 평점
3.6.7 행렬 인수분해 계열의 이해
3.7 분해와 이웃 모델 통합
3.7.1 베이스라인 추정 모델: 개인화되지 않은 바이어스 중심 모델
3.7.2 모델의 이웃 부분
3.7.3 모델의 잠재 요인 부분
3.7.4 이웃 및 잠재 요인 부분의 통합
3.7.5 최적화 모델 풀기
3.7.6 정확도에 대한 고찰
3.7.7 잠재 요인 모델을 임의 모델과 통합
3.8 요약
3.9 참고문헌
3.10 연습 문제
4장. 콘텐츠 기반 추천 시스템
4.1 개요
4.2 콘텐츠 기반 시스템의 기본 구성 요소
4.3 전처리 및 피처 추출
4.3.1 피처 추출
4.3.1.1 상품 추천의 예
4.3.1.2 웹 페이지 추천의 예
4.3.1.3 음악 추천의 예
4.3.2 피처 표현 및 정제
4.3.3 사용자가 좋아하는 것과 싫어하는 것 수집
4.3.4 지도 피처 선택과 가중치 설정
4.3.4.1 지니 계수
4.3.4.2 엔트로피
4.3.4.3 X2-통계
4.3.4.4 정규화된 편차
4.3.4.5 피처 가중치 설정
4.4 사용자 프로파일 학습 및 필터링
4.4.1 최근접 이웃 분류
4.4.2 사례 기반 추천 시스템과의 연결
4.4.3 베이즈 분류 모델
4.4.3.1 중간 확률 추정
4.4.3.2 베이즈 모델의 예
4.4.4 규칙 기반 분류 모델
4.4.4.1 규칙 기반 방법의 예
4.4.5 회귀 기반 모델
4.4.6 기타 학습 모델 및 비교 개요
4.4.7 콘텐츠 기반 시스템에 관한 설명
4.5 콘텐츠 기반 대 협업 필터링 추천
4.6 협업 필터링 시스템을 위한 콘텐츠 기반 모델 사용
4.61 사용자 프로파일 활용
4.7 요약
4.8 참고문헌
4.9 연습 문제
5장. 지식 기반 추천 시스템
5.1 개요
5.2 제약 조건 기반 추천 시스템
5.2.1 관련 결과의 반환
5.2.2 상호작용 방법론
5.2.3 일치하는 아이템의 순위 매기기
5.2.4 허용되지 않는 결과 또는 공집합 처리
5.2.5 제약 조건 추가
5.3 사례 기반 추천
5.3.1 유사도 메트릭
5.3.1.1 유사도 계산에 다양성 통합
5.3.2 수정 방법론
5.3.2.1 간단한 수정
5.3.2.2 복합적 수정
5.3.2.3 동적 수정
5.3.3 수정에 대한 설명
5.4 지식 기반 시스템의 지속적인 개인화
5.5 요약
5.6 참고문헌
5.7 연습 문제
6장. 앙상블 기반과 하이브리드 추천 시스템
6.1 개요
6.2 분류 관점에서 본 앙상블 방법
6.3 가중 하이브리드
6.3.1 다양한 유형의 모델 조합
6.3.2 분류에서 배깅 적응
6.3.3 무작위성의 주입
6.4 스위칭 하이브리드
6.4.1 콜드 스타트 문제를 위한 스위칭 메커니즘
6.4.2 모델 버킷
6.5 캐스케이드 하이브리드
6.5.1 추천의 연속적인 재정의
6.5.2 부스팅
6.5.2.1 가중 기본 모델
6.6 피처 증강 하이브리드
6.7 메타 레벨 하이브리드
6.8 피처 결합 하이브리드
6.8.1 회귀 및 행렬 인수분해
6.8.2 메타 레벨 피처
6.9 혼합 하이브리드
6.10 요약
6.11 참고문헌
6.12 연습 문제
7장. 추천 시스템 평가
7.1 개요
7.2 평가 패러다임
7.2.1 사용자 연구
7.2.2 온라인 평가
7.2.3 과거 데이터 세트를 사용한 오프라인 평가
7.3 평가 디자인의 일반적 목표
7.3.1 정확성
7.3.2 커버리지
7.3.3 신뢰도와 신뢰
7.3.4 참신성
7.3.5 의외성
7.3.6 다양성
7.3.7 강건성과 안정성
7.3.8 확장성
7.4 오프라인 추천 평가의 설계 문제
7.4.1 넷플릭스 프라이즈 데이터 세트 사례 연구
7.4.2 학습 및 테스트 평점 분류
7.4.2.1 홀드 아웃
7.4.2.2 교차 검증
7.4.3 분류 설계와 비교
7.5 오프라인 평가의 정확도 지표
7.5.1 평점 예측의 정확도 측정
7.5.1.1 RMSE 대 MAE
7.5.1.2 롱테일의 영향력
7.5.2 상관관계를 통한 순위 평가
7.5.3 유용성을 통한 순위 평가
7.5.4 수신자 조작 특성을 통한 순위 평가
7.5.5 어떤 순위 측정 척도가 가장 좋은가?
7.6 평가 측정 척도의 한계
7.6.1 평가 조작 방지
7.7 요약
7.8 참고문헌
7.9 연습 문제
8장. 컨텍스트에 맞는 추천 시스템
8.1 개요
8.2 다차원 접근법
8.2.1 계층 구조의 중요성
8.3 컨텍스트 사전 필터링: 감소 기반 접근 방식
8.3.1 앙상블 기반 개선 사항
8.3.2 다단계 추정
8.4 사후 필터링 방법론
8.5 컨텍스트별 모델링
8.5.1 이웃 기반 방법
8.5.2 잠재 요인 모델
8.5.2.1 인수분해 머신
8.5.2.2 2차 인수분해 머신의 일반화
8.5.2.3 잠재 파라미터화의 다른 적용 사례
8.5.3 콘텐츠 기반 모델
8.6 요약
8.7 참고문헌
8.8 연습 문제
9장. 시간과 위치에 민감한 추천 시스템
9.1 개요
9.2 시간적 협업 필터링
9.2.1 최신성 기반 모델
9.2.1.1 감쇠 기반 방법
9.2.1.2 윈도우 기반 방법
9.2.2 주기적 컨텍스트 처리
9.2.2.1 사전 필터링과 사후 필터링
9.2.2.2 시간적 컨텍스트의 직접적인 포함
9.2.3 시간 함수로서의 평점 모델링
9.2.3.1 시간-SVD++ 모델
9.3 이산 시간 모델
9.3.1 마르코프 모델
9.3.1.1 선택적 마르코프 모델
9.3.1.2 다른 마르코프 대안
9.3.2 순차 패턴 마이닝
9.4 위치 인식 추천 시스템
9.4.1 선호 지역
9.4.2 여행 지역
9.4.3 선호도와 여행 위치 조합
9.5 요약
9.6 참고문헌
9.7 연습 문제
10장. 네트워크의 구조 추천
10.1 개요
10.2 순위 알고리듬
10.2.1 페이지랭크
10.2.2 개인화된 페이지랭크
10.2.3 이웃 기반 방법에 대한 응용
10.2.3.1 소셜 네트워크 추천
10.2.3.2 이종 소셜 미디어의 개인화
10.2.3.3 전통적인 협업 필터링
10.2.4 유사도랭크
10.2.5 검색과 추천의 관계
10.3 집단 분류에 의한 추천
10.3.1 반복 분류 알고리듬
10.3.2 랜덤 워크를 통한 레이블 전파
10.3.3 소셜 네트워크에서 협업 필터링에 대한 적용성
10.4 친구 추천: 링크 예측
10.4.1 이웃 기반 척도
10.4.2 카츠 척도
10.4.3 랜덤 워크 기반 척도
10.4.4 분류 문제로서의 링크 예측
10.4.5 링크 예측을 위한 행렬 인수분해
10.4.5.1 대칭 행렬 인수분해
10.4.6 링크 예측과 협업 필터링 간의 연결
10.4.6.1 협업 필터링에 링크 예측 알고리듬 사용
10.4.6.2 협업 필터링 알고리듬을 사용한 링크 예측
10.5 사회적 영향 분석 및 입소문 마케팅
10.5.1 선형 임계값 모델
10.5.2 독립 캐스케이드 모델
10.5.3 영향 함수 평가
10.5.4 소셜 스트림의 목표 영향 분석 모델
10.6 요약
10.7 참고문헌
10.8 연습 문제
11장. 사회와 신뢰 중심 추천 시스템
11.1 개요
11.2 사회적 맥락을 위한 다차원 모델
11.3 네트워크 중심과 신뢰 중심 방법론
11.3.1 신뢰 네트워크 구축을 위한 데이터 수집
11.3.2 신뢰 전파 및 집계
11.3.3 신뢰 전파가 없는 단순 추천 모델
11.3.4 TidalTrust 알고리듬
11.3.5 MoleTrust 알고리듬
11.3.6 TrustWalker 알고리듬
11.3.7 링크 예측 방법론
11.3.8 행렬 인수분해 방법론
11.3.8.1 로지스틱 함수의 개선
11.3.8.2 소셜 신뢰 성분의 변형
11.3.9 소셜 추천 시스템의 장점
11.3.9.1 논란의 여지가 있는 사용자와 아이템에 대한 추천
11.3.9.2 콜드 스타트의 유용성
11.3.9.3 공격 저항
11.4 소셜 추천 모델의 사용자 상호작용
11.4.1 포크소노미 표현하기
11.4.2 소셜 태깅 시스템의 협업 필터링
11.4.3 의미 있는 태그 선택
11.4.4 평점 행렬이 없는 소셜 태깅 추천 모델
11.4.4.1 컨텍스트 민감 시스템을 위한 다차원 방법론
11.4.4.2 순위 기반 방법론
11.4.4.3 콘텐츠 기반 방법론
11.4.5 평점 행렬을 사용한 소셜 태깅 추천 모델
11.4.5.1 이웃 기반 접근법
11.4.5.2 선형 회귀
11.4.5.3 행렬 인수분해
11.4.5.4 콘텐츠 기반 방법
11.5 요약
11.6 참고문헌
11.7 연습 문제
12장. 공격 방지 추천 시스템
12.1 개요
12.2 공격 모델의 트레이드 오프 이해
12.2.1 공격 영향 계량화
12.3 공격 유형
12.3.1 랜덤 공격
12.3.2 평균 공격
12.3.3 밴드 왜건 공격
12.3.4 인기 공격
12.3.5 사랑/증오 공격
12.3.6 역밴드 왜건 공격
12.3.7 탐지 공격
12.3.8 세그먼트 공격
12.3.9 기본 추천 알고리듬의 효과
12.4 추천 시스템에서 공격 탐지
12.4.1 개인 공격 프로파일 탐지
12.4.2 그룹 공격 프로파일 탐지
12.4.2.1 전처리 방법
12.4.2.2 온라인 방법
12.5 강력한 추천 디자인을 위한 전략
12.5.1 CAPTCHA를 사용한 자동 공격 방지
12.5.2 사회적 신뢰 사용
12.5.3 강력한 추천 알고리듬 설계
12.5.3.1 클러스터링을 이웃 방법에 통합
12.5.3.2 추천 시간 동안 가짜 프로파일 탐지
12.5.3.3 연관 기반 알고리듬
12.5.3.4 강건한 행렬 인수분해
12.6 요약
12.7 참고문헌
12.8 연습 문제
13장. 추천 시스템의 고급 주제
13.1 개요
13.2 순위학습
13.2.1 쌍별 순위학습
13.2.2 목록 순위학습
13.2.3 다른 도메인에서의 순위학습 방법과 비교
13.3 멀티암 밴딧 알고리듬
13.3.1 나이브 알고리듬
13.3.2 e-탐욕 알고리듬
13.3.3 상계(신뢰상한) 방법
13.4 그룹 추천 시스템
13.4.1 협업 및 콘텐츠 기반 시스템
13.4.2 지식 기반 시스템
13.5 다중 기준 추천 시스템
13.5.1 이웃 기반 방법
13.5.2 앙상블 기반 방법
13.5.3 전체 평점 없는 다중 기준 시스템
13.6 추천 시스템의 능동적 학습
13.6.1 이질성 기반 모델
13.6.2 성능 기반 모델
13.7 추천 시스템의 개인정보보호
13.7.1 응축 기반 개인정보보호
13.7.2 고차원 데이터에 대한 도전
13.8 흥미로운 응용 분야
13.8.1 포털 콘텐츠 개인화
13.8.1.1 동적 프로파일러
13.8.1.2 구글 뉴스 개인화
13.8.2 전산 광고 대 추천 시스템
13.8.2.1 멀티암 밴딧의 중요성
13.8.3 상호 추천 시스템
13.8.3.1 하이브리드 방법 활용
13.8.3.2 링크 예측 방법 활용
13.9 요약
13.10 참고문헌
1.1 개요
1.2 추천 시스템의 목표
1.21 추천 애플리케이션의 범위
1.3 추천 시스템의 기본 모델
1.3.1 협업 필터링 모델
1.3.1.1 평점의 종류
1.3.1.2 결측치 분석과의 관계
1.3.1.3 분류와 회귀 모델링의 일반화로써의 협업 필터링
1.3.2 콘텐츠 기반 추천 시스템
1.3.3 지식 기반 추천 시스템
1.3.31 효용 기반 추천 시스템
1.3.4 인구 통계학적 추천 시스템
1.3.5 하이브리드와 앙상블 기반 추천 시스템
1.3.6 추천 시스템의 평가
1.4 추천 시스템의 도메인 특화 과제
1.4.1 컨텍스트 기반 추천 시스템
1.4.2 시간에 민감한 추천 시스템
1.4.3 위치 기반 추천 시스템
1.4.4 소셜 추천 시스템
1.4.4.1 노드와 링크의 구조적 추천
1.4.4.2 사회적 영향을 고려한 제품과 콘텐츠 추천
1.4.4.3 신뢰할 수 있는 추천 시스템
1.4.4.4 소셜 태그 피드백을 활용한 추천
1.5 고급 주제 및 애플리케이션
1.5.1 추천 시스템의 콜드 스타트 문제
1.5.2 공격에 강한 추천 시스템
1.5.3 그룹 추천 시스템
1.5.4 다중 기준 추천 시스템
1.5.5 추천 시스템의 능동 학습
1.5.6 추천 시스템의 개인정보보호
1.5.7 애플리케이션 도메인
1.6 요약
1.7 참고문헌
1.8 연습 문제
2장. 이웃 기반 협업 필터링
2.1 개요
2.2 평점 행렬의 주요 특징
2.3 이웃 기반 방법론의 평점 예측
2.3.1 사용자 기반 이웃 모델
2.3.1.1 유사도 함수 변형
2.3.1.2 예측함수의 변형
2.3.1.3 피어 그룹 필터링의 변형
2.3.1.4 롱테일의 영향
2.3.2 아이템 기반 이웃 모델
2.3.3 효율적 구현 및 계산 복잡성
2.3.4 사용자 기반 방법론과 아이템 기반 방법론의 비교
2.3.5 이웃 기반 방법론의 장점과 단점
2.3.6 사용자 기반과 아이템 기반 방법론의 통합된 관점
2.4 클러스터링과 이웃 기반 방법론
2.5 차원 축소와 이웃 기반 방법론
2.5.1 바이어스 문제 처리
2.5.1.1 최대 우도 추정
2.5.1.2 불완전한 데이터의 직접 행렬 인수분해
2.6 이웃 방법론의 회귀 모델링 관점
2.6.1 사용자 기반 최근접 이웃 회귀
2.6.1.1 희소성 및 바이어스 문제
2.6.2 아이템 기반 가장 근접 이웃 회귀
2.6.3 사용자 기반 및 아이템 기반 방법 결합
2.6.4 유사도 가중치를 이용하는 조인트 보간법
2.6.5 희소 선형 모델(SLIM)
2.7 이웃 기반 방법에 대한 그래프 모델
2.7.1 사용자-아이템 그래프
2.7.1.1 랜덤 워크를 이용한 이웃 정의
2.7.1.2 카츠 척도를 이용한 이웃 정의
2.7.2 사용자-사용자 그래프
2.7.3 아이템-아이템 그래프
2.8 요약
2.9 참고문헌
2.10 연습 문제
3장. 모델 기반 협업 필터링
3.1 개요
3.2 의사 결정 및 회귀 트리
3.2.1 의사 결정 트리를 협업 필터링으로 확장
3.3 규칙 기반 협업 필터링
3.3.1 협업 필터링을 위한 레버리지 연관 규칙의 활용
3.3.2 아이템별 모델 대 사용자별 모델
3.4 나이브 베이즈 협업 필터링
3.4.1 과적합 조정
3.4.2 이진 평점에 대한 베이즈 방법의 적용 예
3.5 임의의 분류 모델을 블랙 박스로 사용
3.5.1 예: 신경망을 블랙 박스로 사용
3.6 잠재 요인 모델
3.6.1 잠재 요인 모델에 대한 기하학적 직관
3.6.2 잠재 요인 모델에 관한 저차원 직관
3.6.3 기본 행렬 인수분해 원리
3.6.4 제약 없는 행렬 인수분해
3.6.4.1 확률적 경사하강법
3.6.4.2 정규화
3.6.4.3 점진적 잠재성분 훈련
3.6.4.4 최소 제곱과 좌표 하강의 교차 적용
3.6.4.5 사용자 및 아이템 바이어스 통합
3.6.4.6 암시적 피드백 통합
3.6.5 특이값 분해
3.6.5.1 SVD에 대한 간단한 반복 접근법
3.6.5.2 최적화 기반 접근법
3.6.5.3 표본 외 추천
3.6.5.4 특이값 분해의 예
3.6.6 비음행렬 인수분해
3.6.6.1 해석 가능성의 장점
3.6.6.2 암시적 피드백을 사용한 인수분해에 대한 고찰
3.6.6.3 암시적 피드백에 대한 계산 및 가중치 문제
3.6.6.4 좋아요와 싫어요가 모두 있는 평점
3.6.7 행렬 인수분해 계열의 이해
3.7 분해와 이웃 모델 통합
3.7.1 베이스라인 추정 모델: 개인화되지 않은 바이어스 중심 모델
3.7.2 모델의 이웃 부분
3.7.3 모델의 잠재 요인 부분
3.7.4 이웃 및 잠재 요인 부분의 통합
3.7.5 최적화 모델 풀기
3.7.6 정확도에 대한 고찰
3.7.7 잠재 요인 모델을 임의 모델과 통합
3.8 요약
3.9 참고문헌
3.10 연습 문제
4장. 콘텐츠 기반 추천 시스템
4.1 개요
4.2 콘텐츠 기반 시스템의 기본 구성 요소
4.3 전처리 및 피처 추출
4.3.1 피처 추출
4.3.1.1 상품 추천의 예
4.3.1.2 웹 페이지 추천의 예
4.3.1.3 음악 추천의 예
4.3.2 피처 표현 및 정제
4.3.3 사용자가 좋아하는 것과 싫어하는 것 수집
4.3.4 지도 피처 선택과 가중치 설정
4.3.4.1 지니 계수
4.3.4.2 엔트로피
4.3.4.3 X2-통계
4.3.4.4 정규화된 편차
4.3.4.5 피처 가중치 설정
4.4 사용자 프로파일 학습 및 필터링
4.4.1 최근접 이웃 분류
4.4.2 사례 기반 추천 시스템과의 연결
4.4.3 베이즈 분류 모델
4.4.3.1 중간 확률 추정
4.4.3.2 베이즈 모델의 예
4.4.4 규칙 기반 분류 모델
4.4.4.1 규칙 기반 방법의 예
4.4.5 회귀 기반 모델
4.4.6 기타 학습 모델 및 비교 개요
4.4.7 콘텐츠 기반 시스템에 관한 설명
4.5 콘텐츠 기반 대 협업 필터링 추천
4.6 협업 필터링 시스템을 위한 콘텐츠 기반 모델 사용
4.61 사용자 프로파일 활용
4.7 요약
4.8 참고문헌
4.9 연습 문제
5장. 지식 기반 추천 시스템
5.1 개요
5.2 제약 조건 기반 추천 시스템
5.2.1 관련 결과의 반환
5.2.2 상호작용 방법론
5.2.3 일치하는 아이템의 순위 매기기
5.2.4 허용되지 않는 결과 또는 공집합 처리
5.2.5 제약 조건 추가
5.3 사례 기반 추천
5.3.1 유사도 메트릭
5.3.1.1 유사도 계산에 다양성 통합
5.3.2 수정 방법론
5.3.2.1 간단한 수정
5.3.2.2 복합적 수정
5.3.2.3 동적 수정
5.3.3 수정에 대한 설명
5.4 지식 기반 시스템의 지속적인 개인화
5.5 요약
5.6 참고문헌
5.7 연습 문제
6장. 앙상블 기반과 하이브리드 추천 시스템
6.1 개요
6.2 분류 관점에서 본 앙상블 방법
6.3 가중 하이브리드
6.3.1 다양한 유형의 모델 조합
6.3.2 분류에서 배깅 적응
6.3.3 무작위성의 주입
6.4 스위칭 하이브리드
6.4.1 콜드 스타트 문제를 위한 스위칭 메커니즘
6.4.2 모델 버킷
6.5 캐스케이드 하이브리드
6.5.1 추천의 연속적인 재정의
6.5.2 부스팅
6.5.2.1 가중 기본 모델
6.6 피처 증강 하이브리드
6.7 메타 레벨 하이브리드
6.8 피처 결합 하이브리드
6.8.1 회귀 및 행렬 인수분해
6.8.2 메타 레벨 피처
6.9 혼합 하이브리드
6.10 요약
6.11 참고문헌
6.12 연습 문제
7장. 추천 시스템 평가
7.1 개요
7.2 평가 패러다임
7.2.1 사용자 연구
7.2.2 온라인 평가
7.2.3 과거 데이터 세트를 사용한 오프라인 평가
7.3 평가 디자인의 일반적 목표
7.3.1 정확성
7.3.2 커버리지
7.3.3 신뢰도와 신뢰
7.3.4 참신성
7.3.5 의외성
7.3.6 다양성
7.3.7 강건성과 안정성
7.3.8 확장성
7.4 오프라인 추천 평가의 설계 문제
7.4.1 넷플릭스 프라이즈 데이터 세트 사례 연구
7.4.2 학습 및 테스트 평점 분류
7.4.2.1 홀드 아웃
7.4.2.2 교차 검증
7.4.3 분류 설계와 비교
7.5 오프라인 평가의 정확도 지표
7.5.1 평점 예측의 정확도 측정
7.5.1.1 RMSE 대 MAE
7.5.1.2 롱테일의 영향력
7.5.2 상관관계를 통한 순위 평가
7.5.3 유용성을 통한 순위 평가
7.5.4 수신자 조작 특성을 통한 순위 평가
7.5.5 어떤 순위 측정 척도가 가장 좋은가?
7.6 평가 측정 척도의 한계
7.6.1 평가 조작 방지
7.7 요약
7.8 참고문헌
7.9 연습 문제
8장. 컨텍스트에 맞는 추천 시스템
8.1 개요
8.2 다차원 접근법
8.2.1 계층 구조의 중요성
8.3 컨텍스트 사전 필터링: 감소 기반 접근 방식
8.3.1 앙상블 기반 개선 사항
8.3.2 다단계 추정
8.4 사후 필터링 방법론
8.5 컨텍스트별 모델링
8.5.1 이웃 기반 방법
8.5.2 잠재 요인 모델
8.5.2.1 인수분해 머신
8.5.2.2 2차 인수분해 머신의 일반화
8.5.2.3 잠재 파라미터화의 다른 적용 사례
8.5.3 콘텐츠 기반 모델
8.6 요약
8.7 참고문헌
8.8 연습 문제
9장. 시간과 위치에 민감한 추천 시스템
9.1 개요
9.2 시간적 협업 필터링
9.2.1 최신성 기반 모델
9.2.1.1 감쇠 기반 방법
9.2.1.2 윈도우 기반 방법
9.2.2 주기적 컨텍스트 처리
9.2.2.1 사전 필터링과 사후 필터링
9.2.2.2 시간적 컨텍스트의 직접적인 포함
9.2.3 시간 함수로서의 평점 모델링
9.2.3.1 시간-SVD++ 모델
9.3 이산 시간 모델
9.3.1 마르코프 모델
9.3.1.1 선택적 마르코프 모델
9.3.1.2 다른 마르코프 대안
9.3.2 순차 패턴 마이닝
9.4 위치 인식 추천 시스템
9.4.1 선호 지역
9.4.2 여행 지역
9.4.3 선호도와 여행 위치 조합
9.5 요약
9.6 참고문헌
9.7 연습 문제
10장. 네트워크의 구조 추천
10.1 개요
10.2 순위 알고리듬
10.2.1 페이지랭크
10.2.2 개인화된 페이지랭크
10.2.3 이웃 기반 방법에 대한 응용
10.2.3.1 소셜 네트워크 추천
10.2.3.2 이종 소셜 미디어의 개인화
10.2.3.3 전통적인 협업 필터링
10.2.4 유사도랭크
10.2.5 검색과 추천의 관계
10.3 집단 분류에 의한 추천
10.3.1 반복 분류 알고리듬
10.3.2 랜덤 워크를 통한 레이블 전파
10.3.3 소셜 네트워크에서 협업 필터링에 대한 적용성
10.4 친구 추천: 링크 예측
10.4.1 이웃 기반 척도
10.4.2 카츠 척도
10.4.3 랜덤 워크 기반 척도
10.4.4 분류 문제로서의 링크 예측
10.4.5 링크 예측을 위한 행렬 인수분해
10.4.5.1 대칭 행렬 인수분해
10.4.6 링크 예측과 협업 필터링 간의 연결
10.4.6.1 협업 필터링에 링크 예측 알고리듬 사용
10.4.6.2 협업 필터링 알고리듬을 사용한 링크 예측
10.5 사회적 영향 분석 및 입소문 마케팅
10.5.1 선형 임계값 모델
10.5.2 독립 캐스케이드 모델
10.5.3 영향 함수 평가
10.5.4 소셜 스트림의 목표 영향 분석 모델
10.6 요약
10.7 참고문헌
10.8 연습 문제
11장. 사회와 신뢰 중심 추천 시스템
11.1 개요
11.2 사회적 맥락을 위한 다차원 모델
11.3 네트워크 중심과 신뢰 중심 방법론
11.3.1 신뢰 네트워크 구축을 위한 데이터 수집
11.3.2 신뢰 전파 및 집계
11.3.3 신뢰 전파가 없는 단순 추천 모델
11.3.4 TidalTrust 알고리듬
11.3.5 MoleTrust 알고리듬
11.3.6 TrustWalker 알고리듬
11.3.7 링크 예측 방법론
11.3.8 행렬 인수분해 방법론
11.3.8.1 로지스틱 함수의 개선
11.3.8.2 소셜 신뢰 성분의 변형
11.3.9 소셜 추천 시스템의 장점
11.3.9.1 논란의 여지가 있는 사용자와 아이템에 대한 추천
11.3.9.2 콜드 스타트의 유용성
11.3.9.3 공격 저항
11.4 소셜 추천 모델의 사용자 상호작용
11.4.1 포크소노미 표현하기
11.4.2 소셜 태깅 시스템의 협업 필터링
11.4.3 의미 있는 태그 선택
11.4.4 평점 행렬이 없는 소셜 태깅 추천 모델
11.4.4.1 컨텍스트 민감 시스템을 위한 다차원 방법론
11.4.4.2 순위 기반 방법론
11.4.4.3 콘텐츠 기반 방법론
11.4.5 평점 행렬을 사용한 소셜 태깅 추천 모델
11.4.5.1 이웃 기반 접근법
11.4.5.2 선형 회귀
11.4.5.3 행렬 인수분해
11.4.5.4 콘텐츠 기반 방법
11.5 요약
11.6 참고문헌
11.7 연습 문제
12장. 공격 방지 추천 시스템
12.1 개요
12.2 공격 모델의 트레이드 오프 이해
12.2.1 공격 영향 계량화
12.3 공격 유형
12.3.1 랜덤 공격
12.3.2 평균 공격
12.3.3 밴드 왜건 공격
12.3.4 인기 공격
12.3.5 사랑/증오 공격
12.3.6 역밴드 왜건 공격
12.3.7 탐지 공격
12.3.8 세그먼트 공격
12.3.9 기본 추천 알고리듬의 효과
12.4 추천 시스템에서 공격 탐지
12.4.1 개인 공격 프로파일 탐지
12.4.2 그룹 공격 프로파일 탐지
12.4.2.1 전처리 방법
12.4.2.2 온라인 방법
12.5 강력한 추천 디자인을 위한 전략
12.5.1 CAPTCHA를 사용한 자동 공격 방지
12.5.2 사회적 신뢰 사용
12.5.3 강력한 추천 알고리듬 설계
12.5.3.1 클러스터링을 이웃 방법에 통합
12.5.3.2 추천 시간 동안 가짜 프로파일 탐지
12.5.3.3 연관 기반 알고리듬
12.5.3.4 강건한 행렬 인수분해
12.6 요약
12.7 참고문헌
12.8 연습 문제
13장. 추천 시스템의 고급 주제
13.1 개요
13.2 순위학습
13.2.1 쌍별 순위학습
13.2.2 목록 순위학습
13.2.3 다른 도메인에서의 순위학습 방법과 비교
13.3 멀티암 밴딧 알고리듬
13.3.1 나이브 알고리듬
13.3.2 e-탐욕 알고리듬
13.3.3 상계(신뢰상한) 방법
13.4 그룹 추천 시스템
13.4.1 협업 및 콘텐츠 기반 시스템
13.4.2 지식 기반 시스템
13.5 다중 기준 추천 시스템
13.5.1 이웃 기반 방법
13.5.2 앙상블 기반 방법
13.5.3 전체 평점 없는 다중 기준 시스템
13.6 추천 시스템의 능동적 학습
13.6.1 이질성 기반 모델
13.6.2 성능 기반 모델
13.7 추천 시스템의 개인정보보호
13.7.1 응축 기반 개인정보보호
13.7.2 고차원 데이터에 대한 도전
13.8 흥미로운 응용 분야
13.8.1 포털 콘텐츠 개인화
13.8.1.1 동적 프로파일러
13.8.1.2 구글 뉴스 개인화
13.8.2 전산 광고 대 추천 시스템
13.8.2.1 멀티암 밴딧의 중요성
13.8.3 상호 추천 시스템
13.8.3.1 하이브리드 방법 활용
13.8.3.2 링크 예측 방법 활용
13.9 요약
13.10 참고문헌
저자 소개

저자 : 차루아가르왈
저자 : 차루 아가르왈
CHARU C. AGGARWAL
뉴욕 요크타운 하이츠의 IBM T. J. 왓슨 리서치 센터의 뛰어난 연구 회원(DRSM)이다. 1993년 IIT KANPUR에서 학사 학위를 받았고 1996년 MIT에서 박사 학위를 받았다. 데이터 마이닝 분야에서 폭넓게 일해왔고, 400개 이상의 논문을 콘퍼런스와 학술지에 발표했으며 80개 이상의 저작 특허권이 있다. 데이터 마이닝에 관한 교과서, 특이치 분석에 관한 포괄적인 책을 포함한 15권의 책을 저술하거나 편집했다. 특허의 상업적 가치 덕분에 IBM에서 마스터 발명가로 세 번이나 지정됐다. 데이터 스트림에서 생물 테러리스트 위협 탐지에 대한 연구로 IBM 기업상(2003)을 수상했고, 프라이버시 기술에 대한 과학적인 공헌으로 IBM 우수 혁신상(2008)을 수상했다.
데이터 스트림 및 고차원적인 작업에 대한 각각의 작업을 인정받아 두 개의 IBM 우수 기술 성과상(2009, 2015)을 수상했다. 응축 기반 프라이버시 보존 데이터 마이닝에 관한 연구로 EDBT 2014 TEST OF TIME AWARD를 수상했다. 또한 데이터 마이닝 분야에서 영향력 있는 연구 공헌에 대한 두 가지 최고상 중 하나인I EEE ICDM 연구 공헌상(2015)을 수상했다.
IEEE 빅데이터 콘퍼런스(2014)의 총괄 공동 의장직과 ACM CIKM 콘퍼런스(2015), IEEE ICDM 콘퍼런스(2015), ACM KDD 콘퍼런스(2016) 프로그램 공동 의장직을 역임했다. 2004년부터 2008년까지 「IEEE TRANSACTIONS ON KNOWLEDGE AND DATA ENGINEERING」의 부편집장으로 일했다. 「ACM TRANSACTIONS ON KNOWLEDGE DISCOVERY FROM DATA」의 부편집장, 「IEEE TRANSACTIONS ON BIG DATA」의 부편집장, 「DATA MINING AND KNOWLEDGE DISCOVERY JOURNAL」과 「ACM SIGKDD EXPLORATION」의 편집장, 「KNOWLEDGE AND INFORMATION SYSTEMS JOURNAL」의 부편집장이다. SPRINGER의 간행물인 「LECTURE NOTES ON SOCIAL NETWORKS」 자문 위원회에서 활동하고 있으며 데이터 마이닝에 관한 SIAM 활동 그룹의 부사장을 역임했다. “CONTRIBUTIONS TO KNOWLEDGE DISCOVERY AND DATA MINING ALGORITHMS”에 관한 SIAM, ACM, IEEE의 펠로우다.
역자 : 박희원
라이스대학교(RICE UNIVERSITY)와 KAIST에서 관련 공부를 했으며, 이후 네이버, MOLOCO, 비바리퍼블리카를 거쳐 현재는 리테일업에서 개인화를 총괄하면서 추천 알고리듬들을 적용한 제품과 마케팅 전략을 만들어내고 있다.
역자 : 이주희
이론적 알고리듬 개발과 분석을 기반으로 실용적인 기술을 개발하고자 한다. 적정한 딥러닝을 활용한 기술 개발을 위해 인공지능 기술을 제어 분야에 접목한 지능제어 기술 분야에 참여해서 연구하고 있다.
역자 : 이진형
데이터에서 숨어 있는 인사이트를 찾는 일을 좋아한다. 11번가에서 데이터 엔지니어와 데이터 과학자 역할 사이에서 판매자와 구매자가 사용하는 개인화 추천 서비스를 제공하기 위해 데이터 파이프라인과 데이터 모델을 개발했으며, 현재는 카드 혜택 통합 관리 핀테크 스타트업 빅쏠에서 데이터 과학자로 일하고 있다.
CHARU C. AGGARWAL
뉴욕 요크타운 하이츠의 IBM T. J. 왓슨 리서치 센터의 뛰어난 연구 회원(DRSM)이다. 1993년 IIT KANPUR에서 학사 학위를 받았고 1996년 MIT에서 박사 학위를 받았다. 데이터 마이닝 분야에서 폭넓게 일해왔고, 400개 이상의 논문을 콘퍼런스와 학술지에 발표했으며 80개 이상의 저작 특허권이 있다. 데이터 마이닝에 관한 교과서, 특이치 분석에 관한 포괄적인 책을 포함한 15권의 책을 저술하거나 편집했다. 특허의 상업적 가치 덕분에 IBM에서 마스터 발명가로 세 번이나 지정됐다. 데이터 스트림에서 생물 테러리스트 위협 탐지에 대한 연구로 IBM 기업상(2003)을 수상했고, 프라이버시 기술에 대한 과학적인 공헌으로 IBM 우수 혁신상(2008)을 수상했다.
데이터 스트림 및 고차원적인 작업에 대한 각각의 작업을 인정받아 두 개의 IBM 우수 기술 성과상(2009, 2015)을 수상했다. 응축 기반 프라이버시 보존 데이터 마이닝에 관한 연구로 EDBT 2014 TEST OF TIME AWARD를 수상했다. 또한 데이터 마이닝 분야에서 영향력 있는 연구 공헌에 대한 두 가지 최고상 중 하나인I EEE ICDM 연구 공헌상(2015)을 수상했다.
IEEE 빅데이터 콘퍼런스(2014)의 총괄 공동 의장직과 ACM CIKM 콘퍼런스(2015), IEEE ICDM 콘퍼런스(2015), ACM KDD 콘퍼런스(2016) 프로그램 공동 의장직을 역임했다. 2004년부터 2008년까지 「IEEE TRANSACTIONS ON KNOWLEDGE AND DATA ENGINEERING」의 부편집장으로 일했다. 「ACM TRANSACTIONS ON KNOWLEDGE DISCOVERY FROM DATA」의 부편집장, 「IEEE TRANSACTIONS ON BIG DATA」의 부편집장, 「DATA MINING AND KNOWLEDGE DISCOVERY JOURNAL」과 「ACM SIGKDD EXPLORATION」의 편집장, 「KNOWLEDGE AND INFORMATION SYSTEMS JOURNAL」의 부편집장이다. SPRINGER의 간행물인 「LECTURE NOTES ON SOCIAL NETWORKS」 자문 위원회에서 활동하고 있으며 데이터 마이닝에 관한 SIAM 활동 그룹의 부사장을 역임했다. “CONTRIBUTIONS TO KNOWLEDGE DISCOVERY AND DATA MINING ALGORITHMS”에 관한 SIAM, ACM, IEEE의 펠로우다.
역자 : 박희원
라이스대학교(RICE UNIVERSITY)와 KAIST에서 관련 공부를 했으며, 이후 네이버, MOLOCO, 비바리퍼블리카를 거쳐 현재는 리테일업에서 개인화를 총괄하면서 추천 알고리듬들을 적용한 제품과 마케팅 전략을 만들어내고 있다.
역자 : 이주희
이론적 알고리듬 개발과 분석을 기반으로 실용적인 기술을 개발하고자 한다. 적정한 딥러닝을 활용한 기술 개발을 위해 인공지능 기술을 제어 분야에 접목한 지능제어 기술 분야에 참여해서 연구하고 있다.
역자 : 이진형
데이터에서 숨어 있는 인사이트를 찾는 일을 좋아한다. 11번가에서 데이터 엔지니어와 데이터 과학자 역할 사이에서 판매자와 구매자가 사용하는 개인화 추천 서비스를 제공하기 위해 데이터 파이프라인과 데이터 모델을 개발했으며, 현재는 카드 혜택 통합 관리 핀테크 스타트업 빅쏠에서 데이터 과학자로 일하고 있다.
도서리뷰
이 책을 읽고 어떤 느낌을 받으셨나요? 리뷰를 남기고 다른 독자들과 함께 공유해보세요.
구매(배송/수령완료) 후 리뷰를 작성하시면 적립금 300원을 드려요!
등록된 리뷰가 없습니다
첫번째 리뷰어가 되어주세요
이 분야에서 요즘 뜨는 책


에러가 무섭지 않게 되는 책 - 에러 잘 읽는 법부터 효율적으로 디버깅하고 디버깅이 쉬운 코드를 작성하는 법까지사쿠라바 히로유키, 모치즈키 고타로 | 제이펍

AI혁신:개정판 - 나의 커리어를 높이는 스마트워크 전략박대형, 김상용, 차명일, 임성기 | 지식과감성

인생 언리얼 5 프로젝트 교과서 - 언리얼 엔진으로 3D 이머시브 콘텐츠 개발이영호, 박원석, 박현상, 탁광욱, 이영훈, 김현진 | BM성안당

비전공자를 위한 이해할 수 있는 파이썬 - 챗GPT 시대에 최적화된 파이썬 공부법최원영 | 티더블유아이지

엔트리 인공지능 with 햄스터 로봇 - 개정판강윤지,박찬규,강성웅,김원유,심재민,김연구,홍성용,김경상,정인재 | 영진닷컴

에러가 무섭지 않게 되는 책 - 에러 잘 읽는 법부터 효율적으로 디버깅하고 디버깅이 쉬운 코드를 작성하는 법까지사쿠라바 히로유키, 모치즈키 고타로 | 제이펍

AI혁신:개정판 - 나의 커리어를 높이는 스마트워크 전략박대형, 김상용, 차명일, 임성기 | 지식과감성

인생 언리얼 5 프로젝트 교과서 - 언리얼 엔진으로 3D 이머시브 콘텐츠 개발이영호, 박원석, 박현상, 탁광욱, 이영훈, 김현진 | BM성안당

비전공자를 위한 이해할 수 있는 파이썬 - 챗GPT 시대에 최적화된 파이썬 공부법최원영 | 티더블유아이지

엔트리 인공지능 with 햄스터 로봇 - 개정판강윤지,박찬규,강성웅,김원유,심재민,김연구,홍성용,김경상,정인재 | 영진닷컴

에러가 무섭지 않게 되는 책 - 에러 잘 읽는 법부터 효율적으로 디버깅하고 디버깅이 쉬운 코드를 작성하는 법까지사쿠라바 히로유키, 모치즈키 고타로 | 제이펍

AI혁신:개정판 - 나의 커리어를 높이는 스마트워크 전략박대형, 김상용, 차명일, 임성기 | 지식과감성

인생 언리얼 5 프로젝트 교과서 - 언리얼 엔진으로 3D 이머시브 콘텐츠 개발이영호, 박원석, 박현상, 탁광욱, 이영훈, 김현진 | BM성안당
이 분야의 화제의 신간


바이브 코딩 주식 자동매매 with 파이썬 - 오류 없이 돌아가는 AI 투자 자동화천인국, 천명준 | 생능북스

클링 & 씨댄스 - 매일매일 쓰는 영상 생성 편집 AI전은재 | 생능북스

빠르게 따는 컴퓨터활용능력 2급 필기+실기(2027)이강용(컴활킹) | 골든래빗

혼자 해도 프로 선생님처럼 잘 하는 바이브 코딩 - 복붙하고 내 맘대로 바꾸고 직접 만드는 1년 학사일정 완벽 대비 웹앱 만들기윤태영, 박창민. 김미승, 김상백, 남태열, 오성환, 이승우 | 한빛미디어

AI 읽는 힘 보는 힘(AI 문해력 문화력) - AI 시대를 이해하는 두 가지 능력김경수 | 길벗캠퍼스

바이브 코딩 주식 자동매매 with 파이썬 - 오류 없이 돌아가는 AI 투자 자동화천인국, 천명준 | 생능북스

클링 & 씨댄스 - 매일매일 쓰는 영상 생성 편집 AI전은재 | 생능북스

빠르게 따는 컴퓨터활용능력 2급 필기+실기(2027)이강용(컴활킹) | 골든래빗

혼자 해도 프로 선생님처럼 잘 하는 바이브 코딩 - 복붙하고 내 맘대로 바꾸고 직접 만드는 1년 학사일정 완벽 대비 웹앱 만들기윤태영, 박창민. 김미승, 김상백, 남태열, 오성환, 이승우 | 한빛미디어

AI 읽는 힘 보는 힘(AI 문해력 문화력) - AI 시대를 이해하는 두 가지 능력김경수 | 길벗캠퍼스

바이브 코딩 주식 자동매매 with 파이썬 - 오류 없이 돌아가는 AI 투자 자동화천인국, 천명준 | 생능북스

클링 & 씨댄스 - 매일매일 쓰는 영상 생성 편집 AI전은재 | 생능북스

빠르게 따는 컴퓨터활용능력 2급 필기+실기(2027)이강용(컴활킹) | 골든래빗
이 분야의 주간 베스트셀러


한 권으로 끝내는 시나공 컴활 2급 필기+실기 컴퓨터활용능력 2급(2026 대비)길벗알앤디(강윤석, 김용갑, 김우경, 김종일) | 길벗

이지패스 2026 ADsP 데이터분석 준전문가 - 수험서 앱 제공(위키북스 데이터 자격검정 시리즈 9)박현민, 전용문 | 위키북스

한 권으로 끝내는 시나공 컴활 2급 필기+실기 컴퓨터활용능력 2급(2026 대비)길벗알앤디(강윤석, 김용갑, 김우경, 김종일) | 길벗

이지패스 2026 ADsP 데이터분석 준전문가 - 수험서 앱 제공(위키북스 데이터 자격검정 시리즈 9)박현민, 전용문 | 위키북스

한 권으로 끝내는 시나공 컴활 2급 필기+실기 컴퓨터활용능력 2급(2026 대비)길벗알앤디(강윤석, 김용갑, 김우경, 김종일) | 길벗

이지패스 2026 ADsP 데이터분석 준전문가 - 수험서 앱 제공(위키북스 데이터 자격검정 시리즈 9)박현민, 전용문 | 위키북스
이 분야의 새로 나온 도서


나노바나나&포토샵 디자인 아이디어북코네크리, 이토쿠니 | 영진닷컴

AI와 패션 색채 디자인(AI문고)손현지 | 커뮤니케이션북스

AI와 패션 색채 디자인(큰글자책)(AI문고)손현지 | 커뮤니케이션북스

AI 파이썬 논문 비서문창권, 박수용, 윤일식 | 탐진출판사

AI 위험 구조(AI문고)유지연 | 커뮤니케이션북스

AI 위험 구조(큰글자책)(AI문고)유지연 | 커뮤니케이션북스

AI와 신어(AI문고)남신혜, 유세인 | 커뮤니케이션북스

AI와 신어(큰글자책)(AI문고)남신혜, 유세인 | 커뮤니케이션북스

나노바나나&포토샵 디자인 아이디어북코네크리, 이토쿠니 | 영진닷컴

AI와 패션 색채 디자인(AI문고)손현지 | 커뮤니케이션북스

AI와 패션 색채 디자인(큰글자책)(AI문고)손현지 | 커뮤니케이션북스

AI 파이썬 논문 비서문창권, 박수용, 윤일식 | 탐진출판사

AI 위험 구조(AI문고)유지연 | 커뮤니케이션북스

AI 위험 구조(큰글자책)(AI문고)유지연 | 커뮤니케이션북스

AI와 신어(AI문고)남신혜, 유세인 | 커뮤니케이션북스

AI와 신어(큰글자책)(AI문고)남신혜, 유세인 | 커뮤니케이션북스
교환/반품/환불
| 반품/교환방법 |
|
|---|---|
| 반품/교환 가능기간 |
|
| 반품/교환비용 |
|
| 반품/교환 불가 사유 |
|
| 상품 품절 |
|
| 소비자 피해보상 환불지연에 따른 배상 |
|
등록 페이지로 이동
공지사항공지더보기
- [이벤트 당첨자 발표] 하나은행 나라사랑카드 <전역 PACK 도서 리뷰 작성 이벤트> 당첨자 안내
- [이벤트 당첨자 발표] 26년 9월 <이달의 작가> 댓글 이벤트 당첨자 안내
- [이벤트 당첨자 발표] 8월 모두의 서가 이벤트 당첨자 판매금액 리워드 안내
- [이벤트 당첨자 발표] 26년 8월 <리뷰왕을 찾아라> 이벤트 당첨자 안내
- [이벤트 당첨자 발표] 서울국제정원박람회, 김진명 작가 북토크 당첨자 안내